본문으로 건너뛰기

SWE-2, 첫 코드 수정까지 48단계에서 18단계로

Cognition의 새 코딩 모델은 필요한 파일을 골라 먼저 수정에 들어가요. 성공과 작업 비용을 함께 학습하는 방식이 행동을 어떻게 바꿨는지 살펴봐요.

AI피셜 편집부· 8분 읽기원문 보기 ↗
Cognition의 SWE-2 공식 발표 이미지
사진: Cognition

TL;DR요약

  • Cognition이 9월 10일 SWE-2를 공개했어요. Devin Desktop과 CLI에서 쓸 수 있으며, 작업과 관련된 코드를 빨리 찾아 수정에 들어가는 능력을 개선했다고 밝혔어요.
  • FrontierCode 1.1 Main의 100개 과제를 모델별로 세 번씩 실행했을 때, SWE-2 medium의 첫 수정 중앙값은 18단계로 이전 SWE-1.7의 48단계보다 줄었어요.
  • 같은 평가에서 전체 평균 단계는 127→53, 평균 비용은 81% 감소했고 점수는 높아졌어요. 준비 작업을 줄여 실제 수정에 더 빨리 도달했다는 회사 결과예요.
  • 학습할 때 과제 성공에 보상을 주고, 추론 비용과 실행 시간에 따른 비용을 뺐어요. Cognition은 이런 방식이 필요한 파일을 가려내고 불필요한 탐색을 줄이는 행동에 도움이 됐다고 설명해요.
SWE-2 공개, 첫 수정 중앙값 48단계에서 18단계, 평균 127단계에서 53단계, medium 비용 81% 감소, 시험별 차이와 실제 작업 비교를 설명하는 여섯 컷
단계와 비용 비교는 FrontierCode 1.1 Main의 SWE-1.7 대비 SWE-2 medium 자체 평가예요.· 그림: AI 생성 이미지 (gpt-image-2)

핵심 사실

첫 수정 중앙값
48→18단계SWE-1.7 대비 SWE-2 medium · 2026-09-10 공개
전체 작업 평균
127→53단계FrontierCode 1.1 Main · 100개 과제, 모델별 각 3회
평균 비용
81% 감소같은 평가의 SWE-1.7 대비 SWE-2 medium · Cognition 자체 측정

AI가 파일만 읽다가 한참을 보내던 순간

작은 버그 하나를 고쳐 달라고 했는데 AI가 디렉터리를 둘러보고 파일을 거듭 읽기만 할 때가 있죠. 꼼꼼한 준비와 불필요한 탐색의 경계가 어디인지, 기다리는 사람은 알기 어려워요. Cognition도 이전 SWE-1.7 이용자에게서 간단한 일에 지나치게 탐색하고 생각한다는 피드백을 받았다고 밝혔어요. 공식

9월 10일 나온 SWE-2는 그 행동을 바꾸는 데 초점을 맞췄어요. 파일을 읽고 코드를 수정하고 시험을 실행하는 코딩 에이전트(coding agent)의 모델이며, Devin Desktop과 CLI에서 제공돼요. 회사는 관련 있는 코드를 더 잘 가려내면서 구현을 일찍 시작한다고 설명해요. 공식

48단계 뒤 첫 수정이 18단계로

회사 자체 평가인 FrontierCode 1.1 Main에서 SWE-2 medium은 첫 실제 수정까지 중앙값 18단계가 걸렸어요. SWE-1.7은 48단계였죠. 중앙값은 결과를 크기순으로 놓았을 때 가운데에 있는 값이에요. 시간 48분이 18분이 됐다는 숫자가 아니라, 첫 수정에 도달하기까지의 작업 단계 수예요. 공식

전체 작업의 평균도 127단계에서 53단계로 줄었어요. 회사는 같은 평가에서 점수가 높아지면서 평균 비용은 81% 낮아졌다고 밝혔어요. 100개 과제를 모델별로 세 번씩 실행한 결과이며, 첫 수정의 중앙값과 전체 작업의 평균은 서로 다른 지표예요. 공식
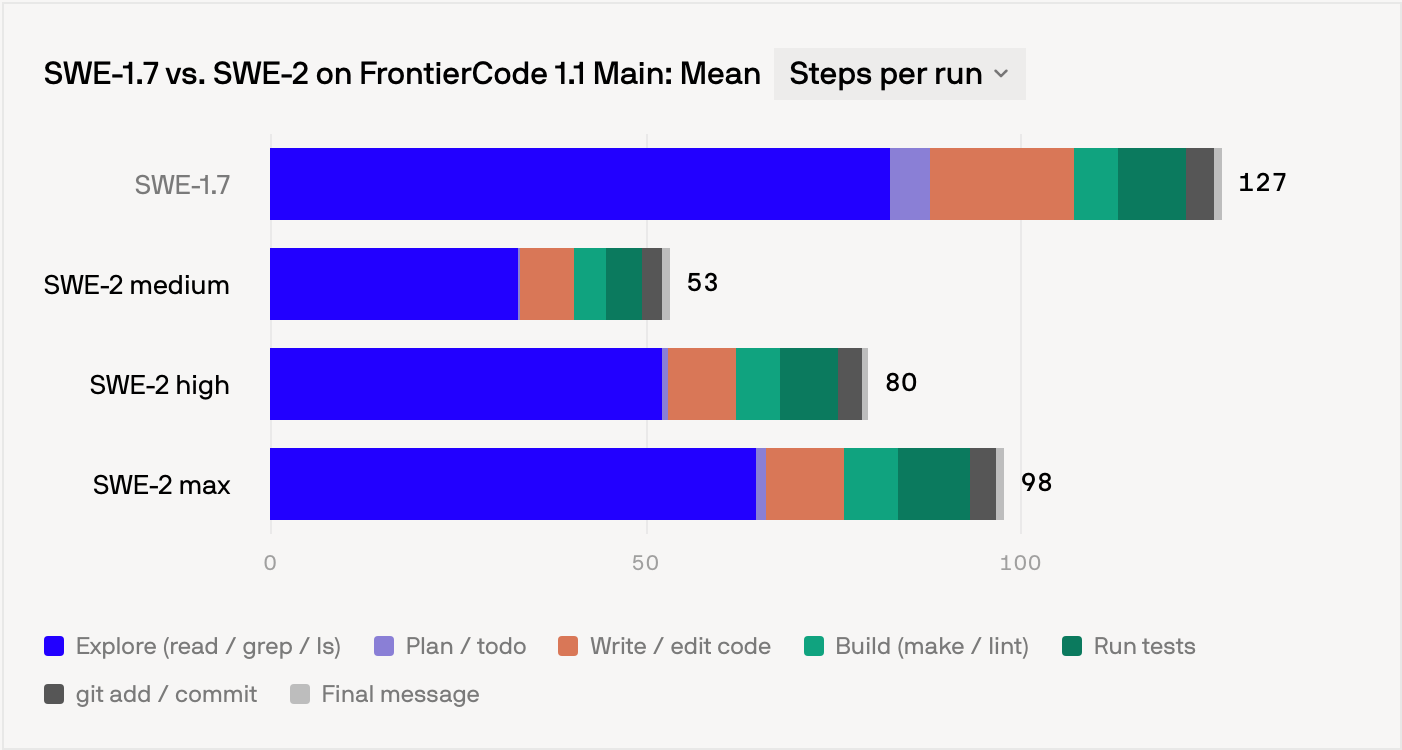
Cognition 원본 누적 막대그래프. SWE-1.7 평균 127단계와 SWE-2 medium 53단계, high 80단계, max 98단계를 탐색·수정·시험 등 작업별 색으로 나눈다
Cognition 발표의 실제 그래프예요. 가로축은 한 실행의 평균 단계 수이고 색은 파일 탐색, 코드 수정, 빌드와 시험 등 작업 종류를 나눠요. 본문의 첫 수정 중앙값 48→18과는 다른, 전체 작업량을 보여주는 그림이에요.· 사진: Cognition 공식 발표 그래프 갈무리

잘 푼 보상에서 실제 작업 비용을 빼요

Cognition은 관련 파일을 가려내는 판단력과 학습 방식이 연결돼 있다고 설명해요. SWE-2의 후속 학습에는 강화학습(reinforcement learning, RL)을 사용했어요. AI가 과제를 수행한 결과에 보상을 매겨, 더 나은 작업 방식을 익히게 하는 과정이에요. 이번에는 성공 여부에 더해 답을 얻는 동안 쓴 추론 비용과 실행 시간을 보상에 직접 반영했어요. 공식

이를테면 같은 버그를 제대로 고치는 두 경로가 있다면, 필요한 파일을 먼저 찾아 고친 경로와 저장소를 두루 헤맨 경로의 학습 보상이 달라지는 거예요. 회사가 공개한 보상식은 성공에 따른 점수에서 작업 비용에 비례하는 값을 빼는 형태예요. 짧게 끝내는 행동만 칭찬하는 것이 아니라, 성공과 그 성공에 드는 비용을 함께 학습 목표로 삼은 것이죠. 공식

비용을 얼마나 크게 반영할지는 추론 강도(effort level)에 맞춰 조정했어요. medium은 단순하거나 중간 난도인 작업에서 일찍 행동하고, high와 max는 복잡한 작업에서 더 많이 계획하고 확인하는 차이를 회사는 관찰했어요. 무조건 탐색을 줄이는 대신, 과제에 맞는 깊이로 생각하게 하려는 방향이에요. Cognition은 이 학습 개선이 행동 변화에 도움이 됐다고 설명해요. 공개된 비교만으로 비용 보상 하나의 효과를 따로 측정한 것은 아니에요. 공식

회사가 든 내부 사례도 판단 방식에 가까워요. 필요한 외부 도구 연결을 쓸 수 없을 때, 이미 접근 권한이 있는 Slack 대화 기록에서 데이터를 재구성했다고 해요. 구현의 처음부터 끝까지 시험하는 능력과, 반문을 받았을 때 결론을 다시 계산해 확인하는 행동도 나아졌다고 보고했어요. 파일을 덜 읽는다는 숫자 뒤에는 무엇이 필요한지 정하고 다른 경로를 찾는 작업이 있어요. 공식

어떤 일을 맡기느냐에 따라 결과도 달라요

공식 비교표의 SWE-2는 FrontierCode 1.1 Main 50.0%로 Fable 5.1의 50.9%에 근접해요. 반면 Terminal-Bench 4에서는 27.3%로 Fable 5.1의 55.8%와 차이가 커요. 실제 저장소에서 자주 하는 수정에 관심이 있는지, 다른 종류의 터미널 작업을 맡기려는지에 따라 볼 행이 달라져요. 공식
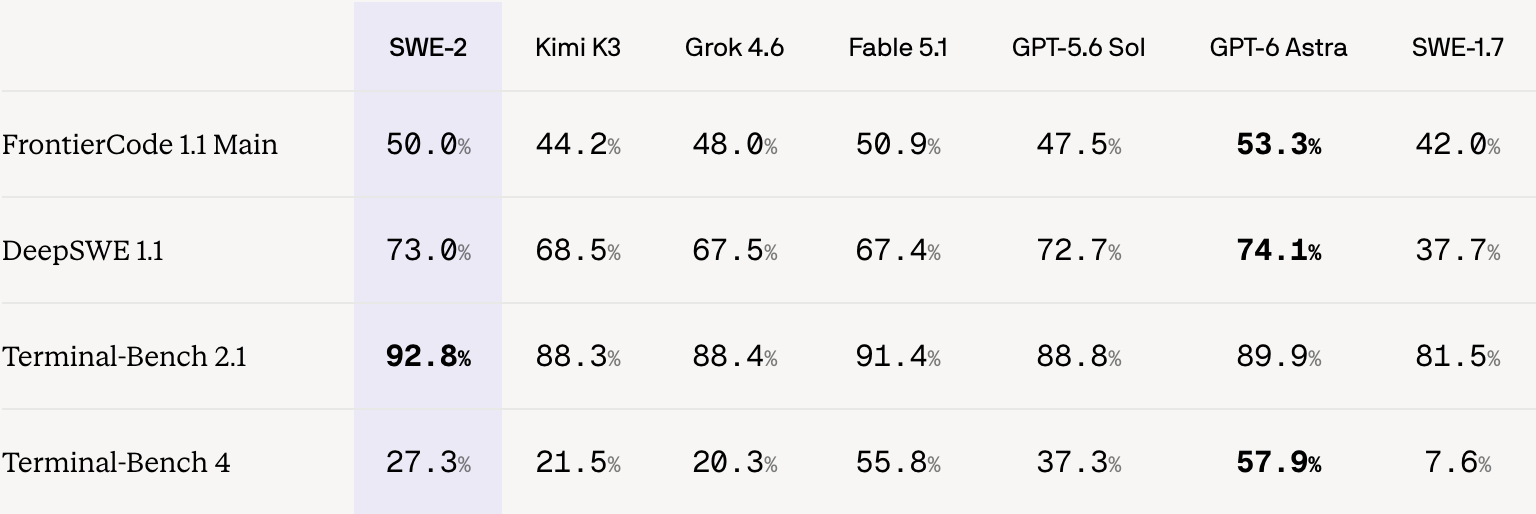
SWE-2 공식 벤치마크 표. FrontierCode, DeepSWE, Terminal-Bench 2.1과 4에서 일곱 모델을 비교한다
SWE-2의 Terminal-Bench 2.1은 92.8%, Terminal-Bench 4는 27.3%예요. 모델별 도구·추론 설정을 쓴 비교표이며, FrontierCode는 필수 조건을 놓치거나 부당하게 정답 코드를 가져온 실행을 0점 처리해요. 앞의 48→18단계·비용 81% 감소는 SWE-1.7과 SWE-2 medium을 비교한 별도 행동 분석이에요.· 사진: Cognition 공식 평가표 갈무리

HN에서는 점수와 사용 장소를 두고 갈렸어요

Hacker News의 mydreamof는 Terminal-Bench 4 성적을 들며 특정 시험에 맞춘 최적화가 아닌지 물었어요. 이는 이용자의 의문이지 평가 오염이 확인됐다는 뜻은 아니에요. 실제로 확인할 수 있는 사실은 회사가 공개한 시험 간 점수 차이예요. 보도

scronkfinkle은 Devin이라는 별도 제품을 거쳐야 한다는 점 때문에 시험해 보기를 망설인다고 썼어요. 새 모델이 좋아졌다는 이야기와, 이미 쓰는 작업 도구에 쉽게 넣을 수 있는지는 다른 문제인 셈이에요. 공식 발표는 Desktop·CLI 제공과 Web·Fusion의 순차 적용을 안내해요. 보도
자주 묻는 질문

제 업무도 같은 비율로 빨라질까요?
회사 시험 결과를 그대로 적용할 수는 없어요. 자주 맡기는 수정 작업으로 시간과 결과 품질을 함께 비교해 보세요.
시험에서 인터넷 답을 가져오면 어떡하나요?
FrontierCode 1.1은 문서 검색과 정답 코드 열람을 구분해요. 정답을 얻는 부당한 인터넷 사용이 감지된 실행에는 0점을 줍니다.

출처 · 3건

  1. 1Cognition SWE-2 발표와 평가 방법공식 발표cognition.com/blog/swe-2
  2. 2FrontierCode 1.1 평가 설계공식 발표cognition.com/blog/frontier-code-1.1
  3. 3SWE-2 HN 토론: 시험별 성능과 Devin 사용 경험보도news.ycombinator.com/item?id=49645443

이 글의 마크다운 원문: /posts/swe-two-coding-cost/md/ · 인용 시 출처를 “AI피셜”으로 표기해 주세요.

편집장의 새 책《의료 바이오 연구자를 위한 AI 신약개발 실전 가이드》 책 표지

의료 바이오 연구자를 위한
AI 신약개발 실전 가이드

Python 기초부터 QSAR·ChemBERTa·GNN,
분자 도킹까지 548쪽 실습서입니다.

책 소개 보기

도움이 됐다면

공유

더보기

다음으로 읽을 글

같은 태그·카테고리에서 세 편을 골랐습니다.

Shopify의 네이티브 앱 전환 공식 발표 이미지
AI 활용· 8분

AI 덕에 두 번 만든다? Shopify의 앱 대전환

한 번 만든 코드를 함께 쓰던 Shopify가 Swift와 Kotlin으로 돌아갑니다. AI가 낮춘 중복 개발 비용과 12주 만에 바뀐 Shop 앱을 살펴봐요.

  • #Shopify
  • #코딩 에이전트
  • #앱 개발
밤에 모니터 두 대에 테스트 출력과 소스 코드가 떠 있는 개발자 책상
활용·도구· 6분

테스트 기법 26종 실험 — 지시 없는 쪽이 더 나았다

코딩 에이전트에게 TDD·퍼징·형식 검증을 시켜 Zstd를 구현시킨 실험입니다. 조건마다 160회씩 돌린 결과와, 에이전트가 실제로 무엇을 했는지 정리했습니다.

  • #코딩 에이전트
  • #평가
  • #형식 검증