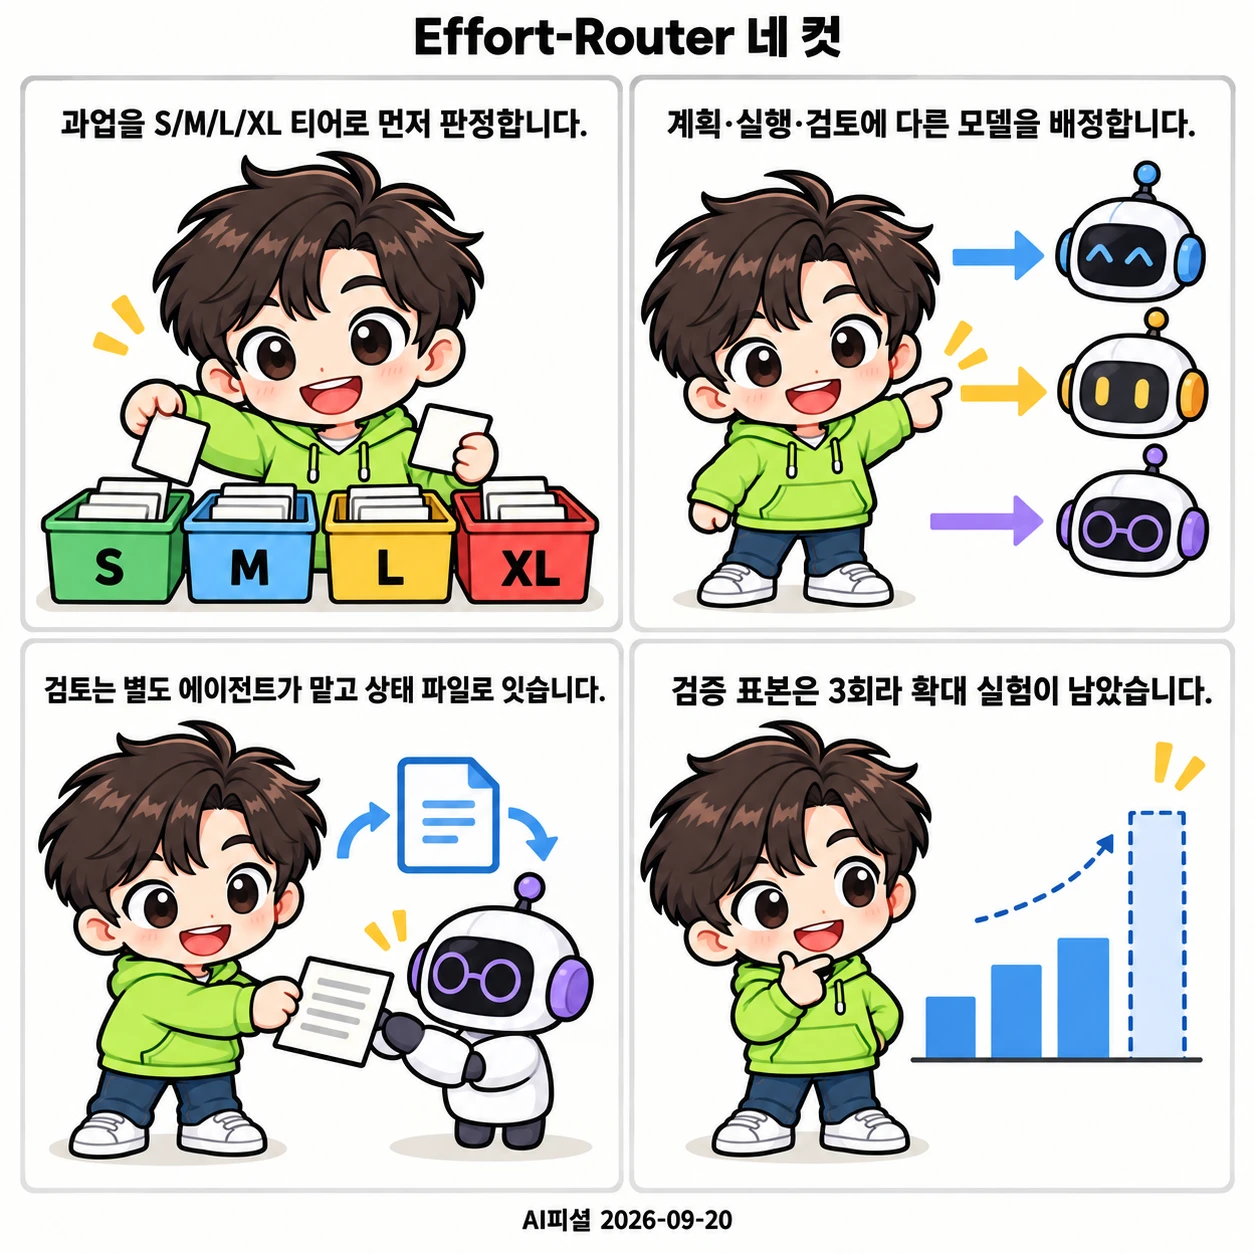
모든 일을 같은 모델로 시키지 않기
코딩 에이전트에게 오타 수정과 결제 모듈 교체를 같은 모델, 같은 추론 깊이로 맡기면 어떻게 될까요. GitHub 사용자 acc0mplish가 2026년 9월 3일 공개한 Effort-Router는 이 질문에서 출발한 Codex·ChatGPT용 스킬(skill, 에이전트가 읽고 따르는 절차 문서 묶음)입니다. 과업의 규모와 위험도를 S/M/L/XL 네 티어로 먼저 판정하고, 그 티어에 따라 계획·실행·검토 단계마다 다른 모델과 추론 깊이(reasoning effort)를 배정합니다. 공식
저자는 필요성을 세 문장으로 요약합니다. 단일 모델·단일 추론 깊이는 단순 수정에 과투자하고 대형 변경은 과소 검증하게 만듭니다. 자기 산출물을 자기가 검토하는 것은 검토가 아닙니다. 서브에이전트 호출은 상태가 없으므로 단계 사이를 잇는 상태 계약이 없으면 인계가 산문 재구성에 의존해 무너집니다. 공식
계획·실행·검토가 서로 다른 모델을 씁니다
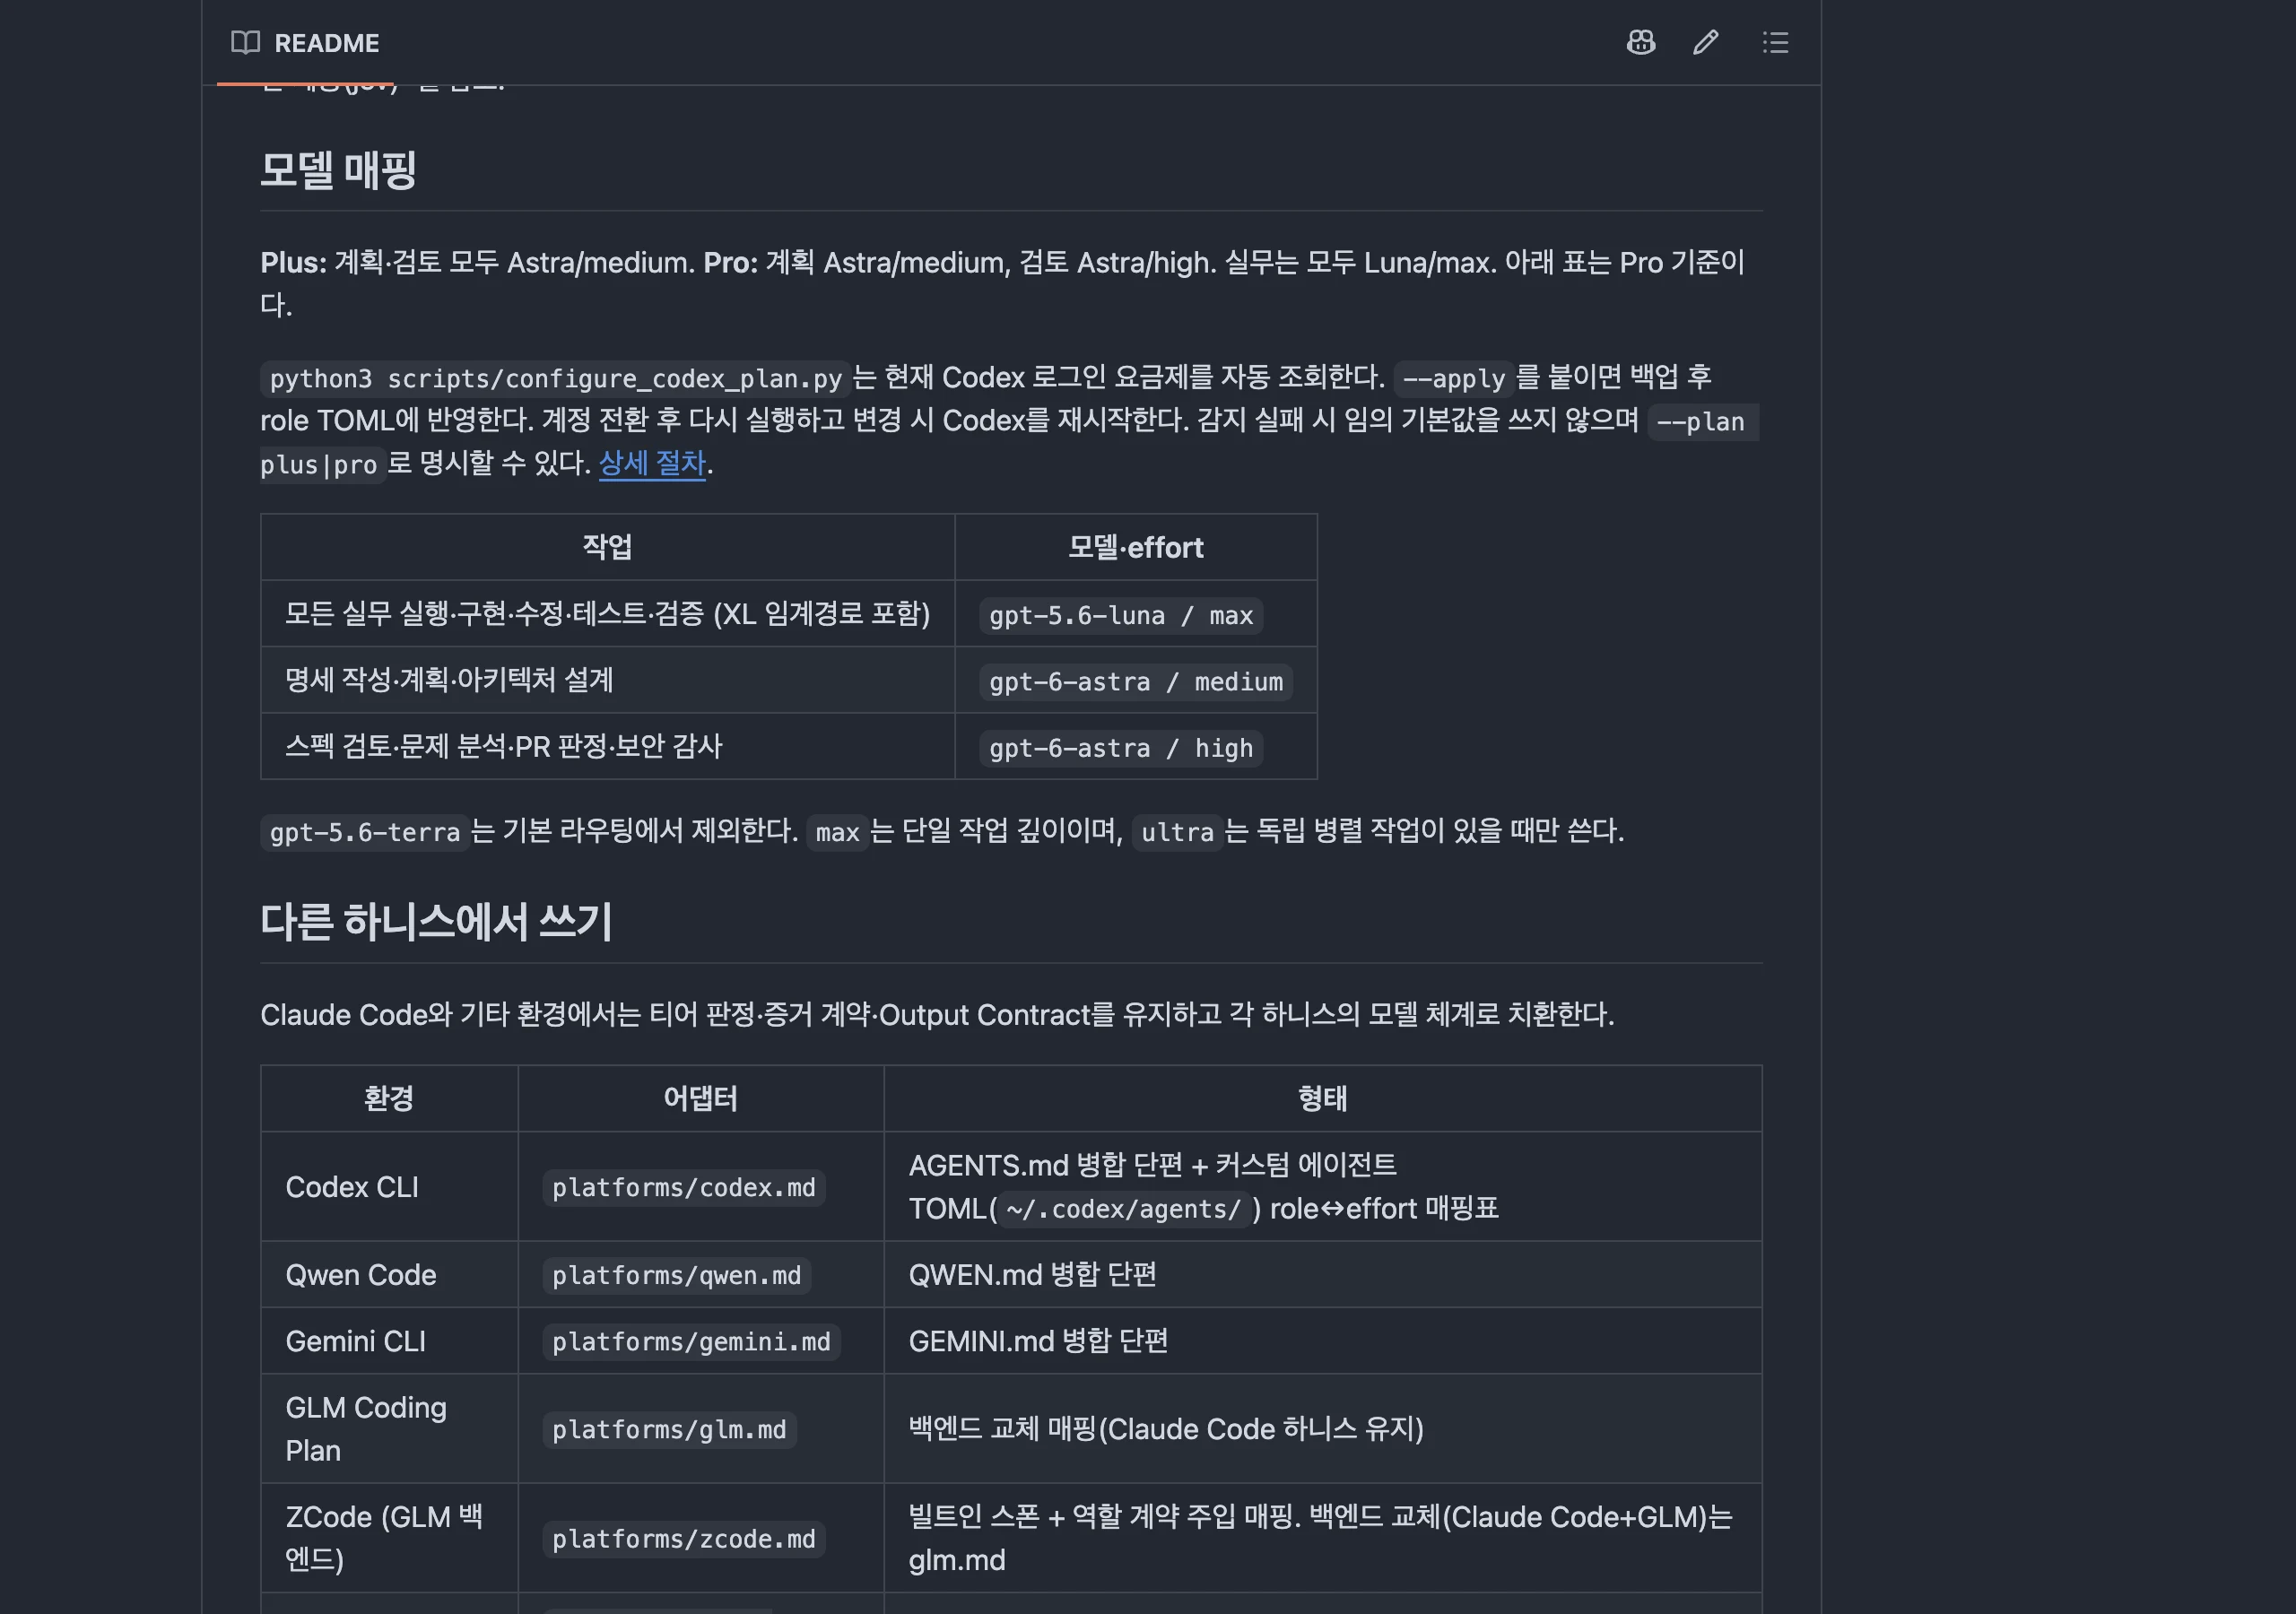
기본 매핑은 명확합니다. 구현·수정·테스트 같은 모든 실무 실행은 GPT-5.6-Luna의 max 추론으로, 명세 작성과 계획·아키텍처 설계는 GPT-6-Astra의 medium으로, 스펙 검토·문제 분석·PR 판정·보안 감사는 Astra의 high로 보냅니다. ChatGPT Plus 요금제에서는 검토도 medium으로 낮추고, 스크립트가 로그인된 요금제를 조회해 역할 설정 파일에 반영합니다. 공식
| 단계 | 모델 | 추론 깊이 |
|---|---|---|
| 실무 실행·구현·테스트 | GPT-5.6-Luna | max |
| 명세·계획·아키텍처 | GPT-6-Astra | medium |
| 검토·PR 판정·보안 감사 | GPT-6-Astra | high (Plus는 medium) |
흐름은 티어 판정, 요구, 수용 기준, 작업, 증거, 학습의 여섯 단계로 이어집니다. 서브에이전트는 state.json을 쓰지 않고 메인 세션만 갱신하며, 완료 보고는 서술이 아니라 실행 명령 원문과 종료 코드로 남기고 상위 세션이 핵심 검증 하나를 다시 실행합니다. 저자는 라우팅의 본질이 추론 깊이 수치가 아니라 역할과 산출물의 분리라고 강조합니다. 공식
논문 여섯 편에서 끌어온 설계
역할을 계획자·개발자·품질검증으로 나누고 증거 번들과 계보를 남기는 구조는 Harness-of-Harness 논문에서, state.json 같은 최소 정보 상태 계약은 SKILL.state 논문에서 가져왔다고 밝힙니다. 반복 3회가 원샷 대비 17~22점 높았다는 관측을 인용하며 이득의 원천은 호출량이 아니라 호출 사이를 잇는 상태라고 해석합니다. 논문
선택 기능인 jev 판단 계층은 TypeSafe의 Jev API로 티어·중복·루프·완료 여부 같은 예·아니오 판정을 서브에이전트를 띄우기 전에 내립니다. 저자는 판정 한 번의 비용을 약 0.3초와 약 1,200토큰으로 적고, 네 갈래 이상의 선택이나 간접 관련성 판단에는 쓸 수 없다는 한계 표도 함께 실었습니다. 이는 AI피셜이 다룬 Jev를 실제 하니스에 붙인 사례이기도 합니다. 공식
검증 기록은 아직 작습니다
저장소의 TESTS.md는 같은 과업을 스킬 없이 1회, 스킬을 주입해 3회 투입한 결과를 기록합니다. 스킬 없는 조건에서는 설치되지 않은 에이전트 네 종을 지목했고 티어 체계 없이 재량으로 모델을 골랐습니다. 스킬 조건에서는 티어 일치율 3/3, 테이블 밖 에이전트 지목률 0/3을 보였습니다. 표본이 작다는 점은 저자가 먼저 적었고, 과업 5개에 3회 반복하는 확대 실험은 후속 과제로 남아 있습니다. 데이터
같은 문서에는 개정 뒤 재검증에서 한 표본의 인용이 본문과 반대였다는 정정도 남아 있습니다. 관측된 실패 한 건을 규칙 한 줄로 바꾼다는 이 스킬의 원칙이 자기 검증 문서에도 적용된 셈입니다. 저장소는 공개 3주 차이고 별표는 한 자릿수이며 라이선스 파일은 아직 없습니다. 시험해 볼 때는 개인 환경에서 설정 백업을 먼저 두는 편이 안전합니다. 데이터