본문으로 건너뛰기

TimesFM-3 공개 — 3.3억 파라미터 다변량 예측 모델

Google Research가 8월 31일 공개한 시계열 파운데이션 모델입니다. 공변량 포함 다변량 예측을 한 번의 순전파로 처리하고 세 벤치마크 1위를 주장하지만, 가중치는 비상업 라이선스입니다.

AI피셜 편집부· 7분 읽기원문 보기 ↗
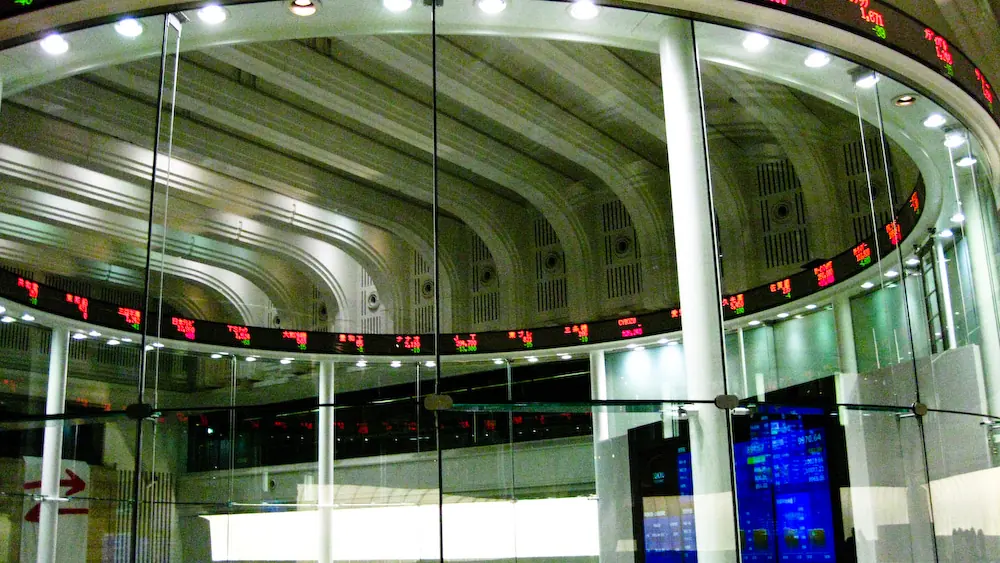
도쿄증권거래소 마켓센터의 원형 시세 전광판
사진: ehnmark · CC BY 2.0

TL;DR요약

  • TimesFM-3는 3억 3,000만 파라미터, 1조 개 넘는 시점의 실제·합성 데이터로 사전학습한 시계열 파운데이션 모델입니다.
  • 이전 버전과 달리 여러 목표 변수, 과거 공변량, 과거·미래 동적 공변량을 기본 지원하며 Contiguous Patch Masking으로 한 번의 순전파에 예측을 끝냅니다.
  • Google은 Gift-Eval, FEV-Bench, TIME 세 벤치마크에서 점 예측과 확률 예측 모두 사전학습 모델 중 1위라고 밝혔고, 비교 대상은 Chronos-2, Toto 2.0, TimesFM-2.5입니다.
  • 코드는 Apache-2.0이지만 사전학습 가중치는 TimesFM 비상업 라이선스 v1.0이라 상업·프로덕션 사용이 금지됩니다. BigQuery 통합은 몇 주 안에 예정입니다.

핵심 사실

발표일
2026-08-31Google Research 블로그, Ayush Jain·Rajat Sen
파라미터
3억 3,000만공식 블로그 기준
학습 데이터
1조 개 이상 시점실제 + 합성 시계열
확률 예측
9개 분위수10~90 백분위
컨텍스트 길이
최대 16kGitHub README, 이전 2048
가중치 라이선스
비상업 v1.0코드는 Apache-2.0

무슨 일인가요

2026년 8월 31일, Google Research의 Ayush Jain과 Rajat Sen은 시계열 파운데이션 모델 TimesFM-3를 공개했습니다. 공식 모델은 3억 3,000만 파라미터로, 실제와 합성 시계열을 합쳐 1조 개가 넘는 시점 데이터로 사전학습했습니다. 공식 GitHub와 Hugging Face에서 바로 받을 수 있고, BigQuery 통합은 몇 주 안에 나올 예정입니다. 공식

핵심은 "제로샷 다변량"입니다. 이전 TimesFM은 하나의 시계열을 보고 다음 값을 맞히는 단변량 모델이었지만, TimesFM-3는 여러 목표 변수, 과거에만 알려진 공변량, 그리고 미래 값까지 알려진 동적 공변량(예: 예정된 프로모션, 휴일)을 과제별 튜닝 없이 한 번에 넣을 수 있습니다. 공식 예측은 Contiguous Patch Masking이라는 방식으로 반복 생성 대신 한 번의 순전파에 끝나며, 10 백분위부터 90 백분위까지 9개 분위수를 함께 내놓아 확률 예측이 가능합니다. 공식
미국 아이오와주 아데어 풍력 발전 단지의 풍력 터빈
풍력 발전량처럼 날씨·수요·일정이 함께 얽히는 시계열이 공변량을 받는 TimesFM-3가 겨냥하는 문제입니다.· 사진: James St. John · CC BY 2.0

TIMESFM-3 핵심

시계열 예측에 '공변량 포함 제로샷'이 들어왔습니다

  1. 여러 목표 변수 + 과거 공변량 + 과거·미래 동적 공변량을 기본 지원

  2. Contiguous Patch Masking으로 한 번의 순전파에 예측 완료

  3. 9개 분위수(10~90 백분위) 출력으로 확률 예측

  4. Gift-Eval·FEV-Bench·TIME 세 벤치마크에서 사전학습 모델 중 1위 주장

출처: Google Research 블로그 (2026-08-31)

성능은 어떻게 주장하나요

Google은 Gift-Eval, FEV-Bench, TIME 세 벤치마크에서 "점 예측과 확률 예측 지표 모두에서 사전학습 파운데이션 모델 중 최상위"라고 밝혔고, 비교 대상으로 Chronos-2, Toto 2.0 계열, 자사 이전 모델 TimesFM-2.5를 들었습니다. 공식 GitHub README는 FEV-Bench가 100개 과제, TIME이 98개 평가 과제로 구성되며 세 벤치마크 모두 파운데이션 모델 가운데 종합 1위라고 적고 있습니다. 공식 다만 공식 블로그 본문에는 순위만 있고 구체적인 점수표는 실려 있지 않아, 이 글에서는 수치를 인용하지 않습니다.

항목이전 버전TimesFM-3근거
입력 구조단변량다변량 + 공변량Google Research 블로그
예측 방식반복 생성한 번의 순전파 (Contiguous Patch Masking)Google Research 블로그
컨텍스트 길이2048최대 16kGitHub README
확률 출력—9개 분위수 (10~90 백분위)Google Research 블로그
아키텍처—20층, 차원 1280, 어텐션 헤드 16, Variate AttentionHugging Face 모델 카드

Hugging Face 모델 카드는 아키텍처를 "Variate Attention과 CPM Iterative RevIN을 갖춘 Stacked Mixing Transformer"로 설명하며, 컨텍스트 패치 길이 32, 예측 패치 길이 64를 명시합니다. 공식 학습 데이터에는 GiftEvalPretrain 데이터셋, Wikipedia 페이지뷰, Google Trends 질의, 합성 증강 데이터가 포함됩니다. 공식

라이선스가 관건입니다

가장 먼저 확인할 것은 라이선스입니다. 소스 코드는 Apache-2.0이지만, TimesFM 3.0 사전학습 가중치는 별도의 TimesFM 비상업 라이선스 v1.0으로 배포되며 README는 "기본 사전학습 가중치의 상업 또는 프로덕션 사용은 허용되지 않는다"고 명시합니다. 공식 Hugging Face 모델 카드도 같은 라이선스를 표기하고, 아직 어떤 추론 제공자도 이 모델을 배포하지 않았다고 적혀 있습니다. 공식 설치는 pip install timesfm[torch], Apple Silicon에서는 timesfm[mlx]이며, PyTorch 쪽 API 이름은 TimesFM3Evaluator와 ModelConfig, 배치 예측은 predict_batch입니다. 공식

Google이 든 적용 분야는 소매, 금융, 관측성(observability), 제조, 의료, 자연과학입니다. 공식 상업 이용을 원하는 팀이라면 가중치를 직접 받는 대신 몇 주 안에 나올 BigQuery 통합 같은 Google 제품 경로를 기다리는 편이 안전합니다. 추정

그래서 무엇을 보면 되나요

  1. 공변량이 있는 문제부터 시험

    프로모션·휴일·가격처럼 미래 값을 아는 변수가 있는 수요 예측이 이 모델의 설계 목적에 가장 가깝습니다. 단변량 문제라면 2.5 대비 이점이 작을 수 있습니다.

  2. 자기 데이터로 Chronos-2와 비교

    공식 블로그의 1위 주장은 공개 벤치마크 기준입니다. 도메인 데이터에서 Chronos-2, Toto 2.0과 직접 비교해 보는 것이 맞습니다.

  3. 프로덕션 전에 라이선스 검토

    가중치 라이선스가 비상업이므로, 사내 파일럿과 실제 서비스 투입은 법무 확인 없이는 구분해야 합니다.
자주 묻는 질문

TimesFM-2.5와 무엇이 다른가요?
가장 큰 차이는 다변량입니다. 여러 목표 변수와 과거 공변량, 미래 값을 아는 동적 공변량을 과제별 튜닝 없이 함께 넣을 수 있고, 반복 생성 대신 한 번의 순전파로 예측합니다. GitHub README 기준 컨텍스트 길이도 2048에서 최대 16k로 늘었습니다.
회사에서 바로 써도 되나요?
주의가 필요합니다. 소스 코드는 Apache-2.0이지만 기본 사전학습 가중치는 TimesFM 비상업 라이선스 v1.0으로 배포되며, README는 상업·프로덕션 사용이 허용되지 않는다고 명시합니다. 상업 이용은 몇 주 안에 나올 BigQuery 통합 등 Google 제품 경로를 확인해야 합니다.
어떻게 설치하나요?
pip install timesfm[torch] 로 설치하고, Apple Silicon에서는 timesfm[mlx] 를 씁니다. 가중치는 Hugging Face의 google/timesfm-3.0-pytorch에 있습니다.

출처 · 3건

  1. 1TimesFM-3: A zero-shot foundation model for multivariate forecasting (Google Research)공식 발표research.google/blog/timesfm-3-a-zero-shot-foundation-model-for-multivariate-forecasting/
  2. 2google/timesfm-3.0-pytorch 모델 카드 (Hugging Face)공식 발표huggingface.co/google/timesfm-3.0-pytorch
  3. 3google-research/timesfm README (GitHub)데이터github.com/google-research/timesfm

이 글의 마크다운 원문: /posts/timesfm-3-zero-shot-forecasting/md/ · 인용 시 출처를 “AI피셜”으로 표기해 주세요.

편집장의 새 책《의료 바이오 연구자를 위한 AI 신약개발 실전 가이드》 책 표지

의료 바이오 연구자를 위한
AI 신약개발 실전 가이드

Python 기초부터 QSAR·ChemBERTa·GNN,
분자 도킹까지 548쪽 실습서입니다.

책 소개 보기

도움이 됐다면

공유

더보기

다음으로 읽을 글

같은 태그·카테고리에서 세 편을 골랐습니다.

샌프란시스코 파이오니어 빌딩의 벽돌 외관을 올려다본 사진
모델· 7분

ChatGPT Images 2.5 — 지연 최대 50% 감소, 값 동결

OpenAI가 9월 8일 새 이미지 모델을 내놨습니다. 생성 지연이 2.0 대비 최대 50% 줄었고, 스케치와 댓글 편집이 붙었으며 API에는 플레어와 선버스트가 추가됐습니다.

  • #OpenAI
  • #모델 출시
  • #이미지 생성
레코딩 스튜디오의 아날로그 믹싱 콘솔을 조작하는 엔지니어의 손
모델· 5분

Lyria 3.5 공개 — 최대 3분 노래, 곡당 $0.08

Google이 9월 3일 Gemini API에 Lyria 3.5를 공개 프리뷰로 올리고 9월 4일 Gemini 앱에 넣었습니다. 길이·보컬·가격·제한을 정리했습니다.

  • #Google DeepMind
  • #Gemini
  • #모델 출시
3D 그래픽으로 렌더링한 가상 풍경 — 해 질 무렵 들판에 선 낡은 집과 나무
모델· 5분

Runway GWM Worlds 2 — 소리 나는 실시간 월드 모델

Runway가 9월 3일 공개한 GWM Worlds 2는 텍스트·카메라 입력에 반응해 720p 24fps 영상과 48kHz 오디오를 끝없이 생성하는 인터랙티브 월드 모델입니다. 전작과의 차이, 제어 방식, 한계를 정리했습니다.

  • #Runway
  • #월드 모델
  • #영상 생성