본문으로 건너뛰기

StepFun Step 5, 600B 희소 MoE로 비용 경계 밀기

StepFun이 에이전트 작업용 Step 5 Preview를 공개했습니다. 600B 희소 MoE 구조와 벤치마크 점수, 금융 영역 우위를 정리합니다.

AI피셜 편집부· 7분 읽기원문 보기 ↗
AI피셜 AI 마스코트가 Step 5 Preview의 600B MoE 구조와 비용 대비 성능 곡선을 앞에 두고 벤치마크 점수를 비교합니다.
Step 5 Preview는 같은 지능을 더 낮은 비용으로 얻는 경계를 노렸습니다.· 사진: AI 생성 이미지 (ChatGPT 이미지 생성 · Aside 연동)

TL;DR요약

  • Step 5 Preview는 총 600B·활성 27B 매개변수의 희소 MoE 모델로 100만 토큰 문맥과 시각 입력을 지원합니다.
  • DeepSWE v1.1에서 67.7점으로 Kimi K3(67.5), GLM-5.3(66.9)과 나란히 갔고 GPT-6 Astra(74.1)와의 격차를 좁혔습니다.
  • 금융 벤치마크 FrontierFinance에서 66.4점으로 GPT-6 Astra 55.0점을 앞세웠고 인공지능 지수 44점 수준에서 과제당 비용은 더 낮다고 밝혔습니다.
  • 터미널 작업 Terminal-Bench v4에서는 33.3점에 그쳐 GPT-6 Astra(57.9), GLM-5.3(41.9)보다 낮았습니다.
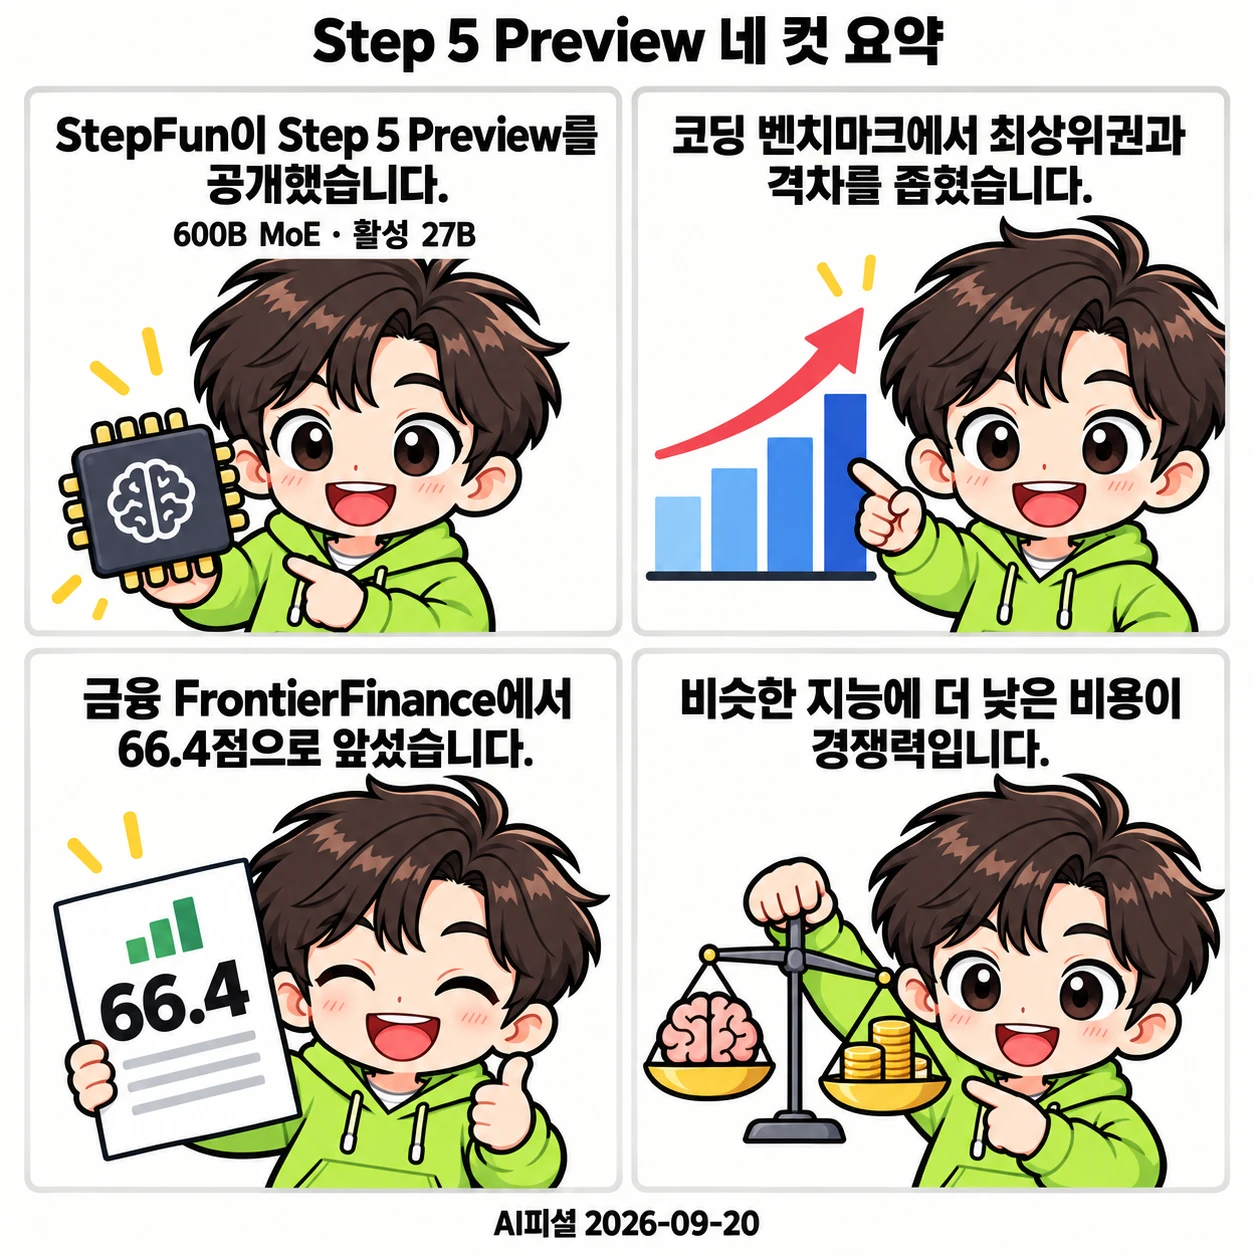
AI피셜 마스코트가 Step 5 Preview의 600B 구조, 소프트웨어 벤치마크 순위, 금융 점수 우위, 낮은 과제 비용을 네 컷으로 설명합니다.
모델 공개부터 벤치마크 해석까지 네 컷으로 정리했습니다.· 그림: AI 생성 이미지 (ChatGPT 이미지 생성 · Aside 연동)

핵심 사실

모델 구조
600B 총·27B 활성희소 전문가 혼합(MoE) 구조이며 토큰당 활성화되는 매개변수 기준입니다.
입력 지원
100만 토큰·시각긴 문맥 창과 이미지 입력을 함께 지원합니다.
FrontierFinance
66.4점GPT-6 Astra 55.0점, Kimi K3 62.6점과의 비교이고 Claude Opus 5는 69.7점입니다.
코딩 자율 평가
약 70%사내외 전문가 평가에서 중간 난도 이상 코딩 과제를 자율 완수할 수 있다고 응답한 비율입니다.

에이전트 일을 겨냥한 600B 희소 모델

StepFun(阶跃星辰)이 2026년 9월 20일 Step 5 Preview를 공개했습니다. 회사는 이 모델을 실제 에이전트 작업을 위한 기반 모델이라고 소개했고, AI 코딩, 소프트웨어 엔지니어링, 전문 지식 노동에서 최고 수준(frontier)의 성능을 겨냥한다고 밝혔습니다. 공식

구조가 먼저 눈에 띕니다. 희소 전문가 혼합(mixture of experts, MoE)은 여러 전문가 네트워크 중 입력마다 일부만 골라 쓰는 기법으로, Step 5 Preview는 총 6,000억 매개변수 가운데 토큰마다 270억 매개변수만 활성화합니다. 문맥 창은 100만 토큰이고 시각 입력도 받습니다. 큰 모델의 지능과 작은 모델의 연산 비용을 함께 노리는 설계입니다. 공식

소프트웨어 벤치마크에서 최상위와 격차를 좁히다

소프트웨어 엔지니어링 벤치마크 DeepSWE v1.1에서 Step 5 Preview는 67.7점을 기록했습니다. Kimi K3(67.5점), GLM-5.3(66.9점)과 사실상 나란히 갔고, GPT-6 Astra(74.1점), Claude Opus 5(74.0점)와의 격차는 과거 세대보다 좁혀졌습니다. 공식

벤치마크Step 5 PreviewKimi K3GLM-5.3GPT-6 AstraClaude Opus 5
DeepSWE v1.167.767.566.974.174.0
StepCodeBench49.043.940.261.063.9
Terminal-Bench v433.312.641.957.952.3

약점도 분명합니다. 터미널 작업을 평가하는 Terminal-Bench v4에서는 33.3점에 그쳐 GLM-5.3(41.9점), GPT-6 Astra(57.9점)보다 낮았습니다. 긴 명령줄 세션을 다루는 능력은 아직 최상위권에 못 미칩니다. 공식
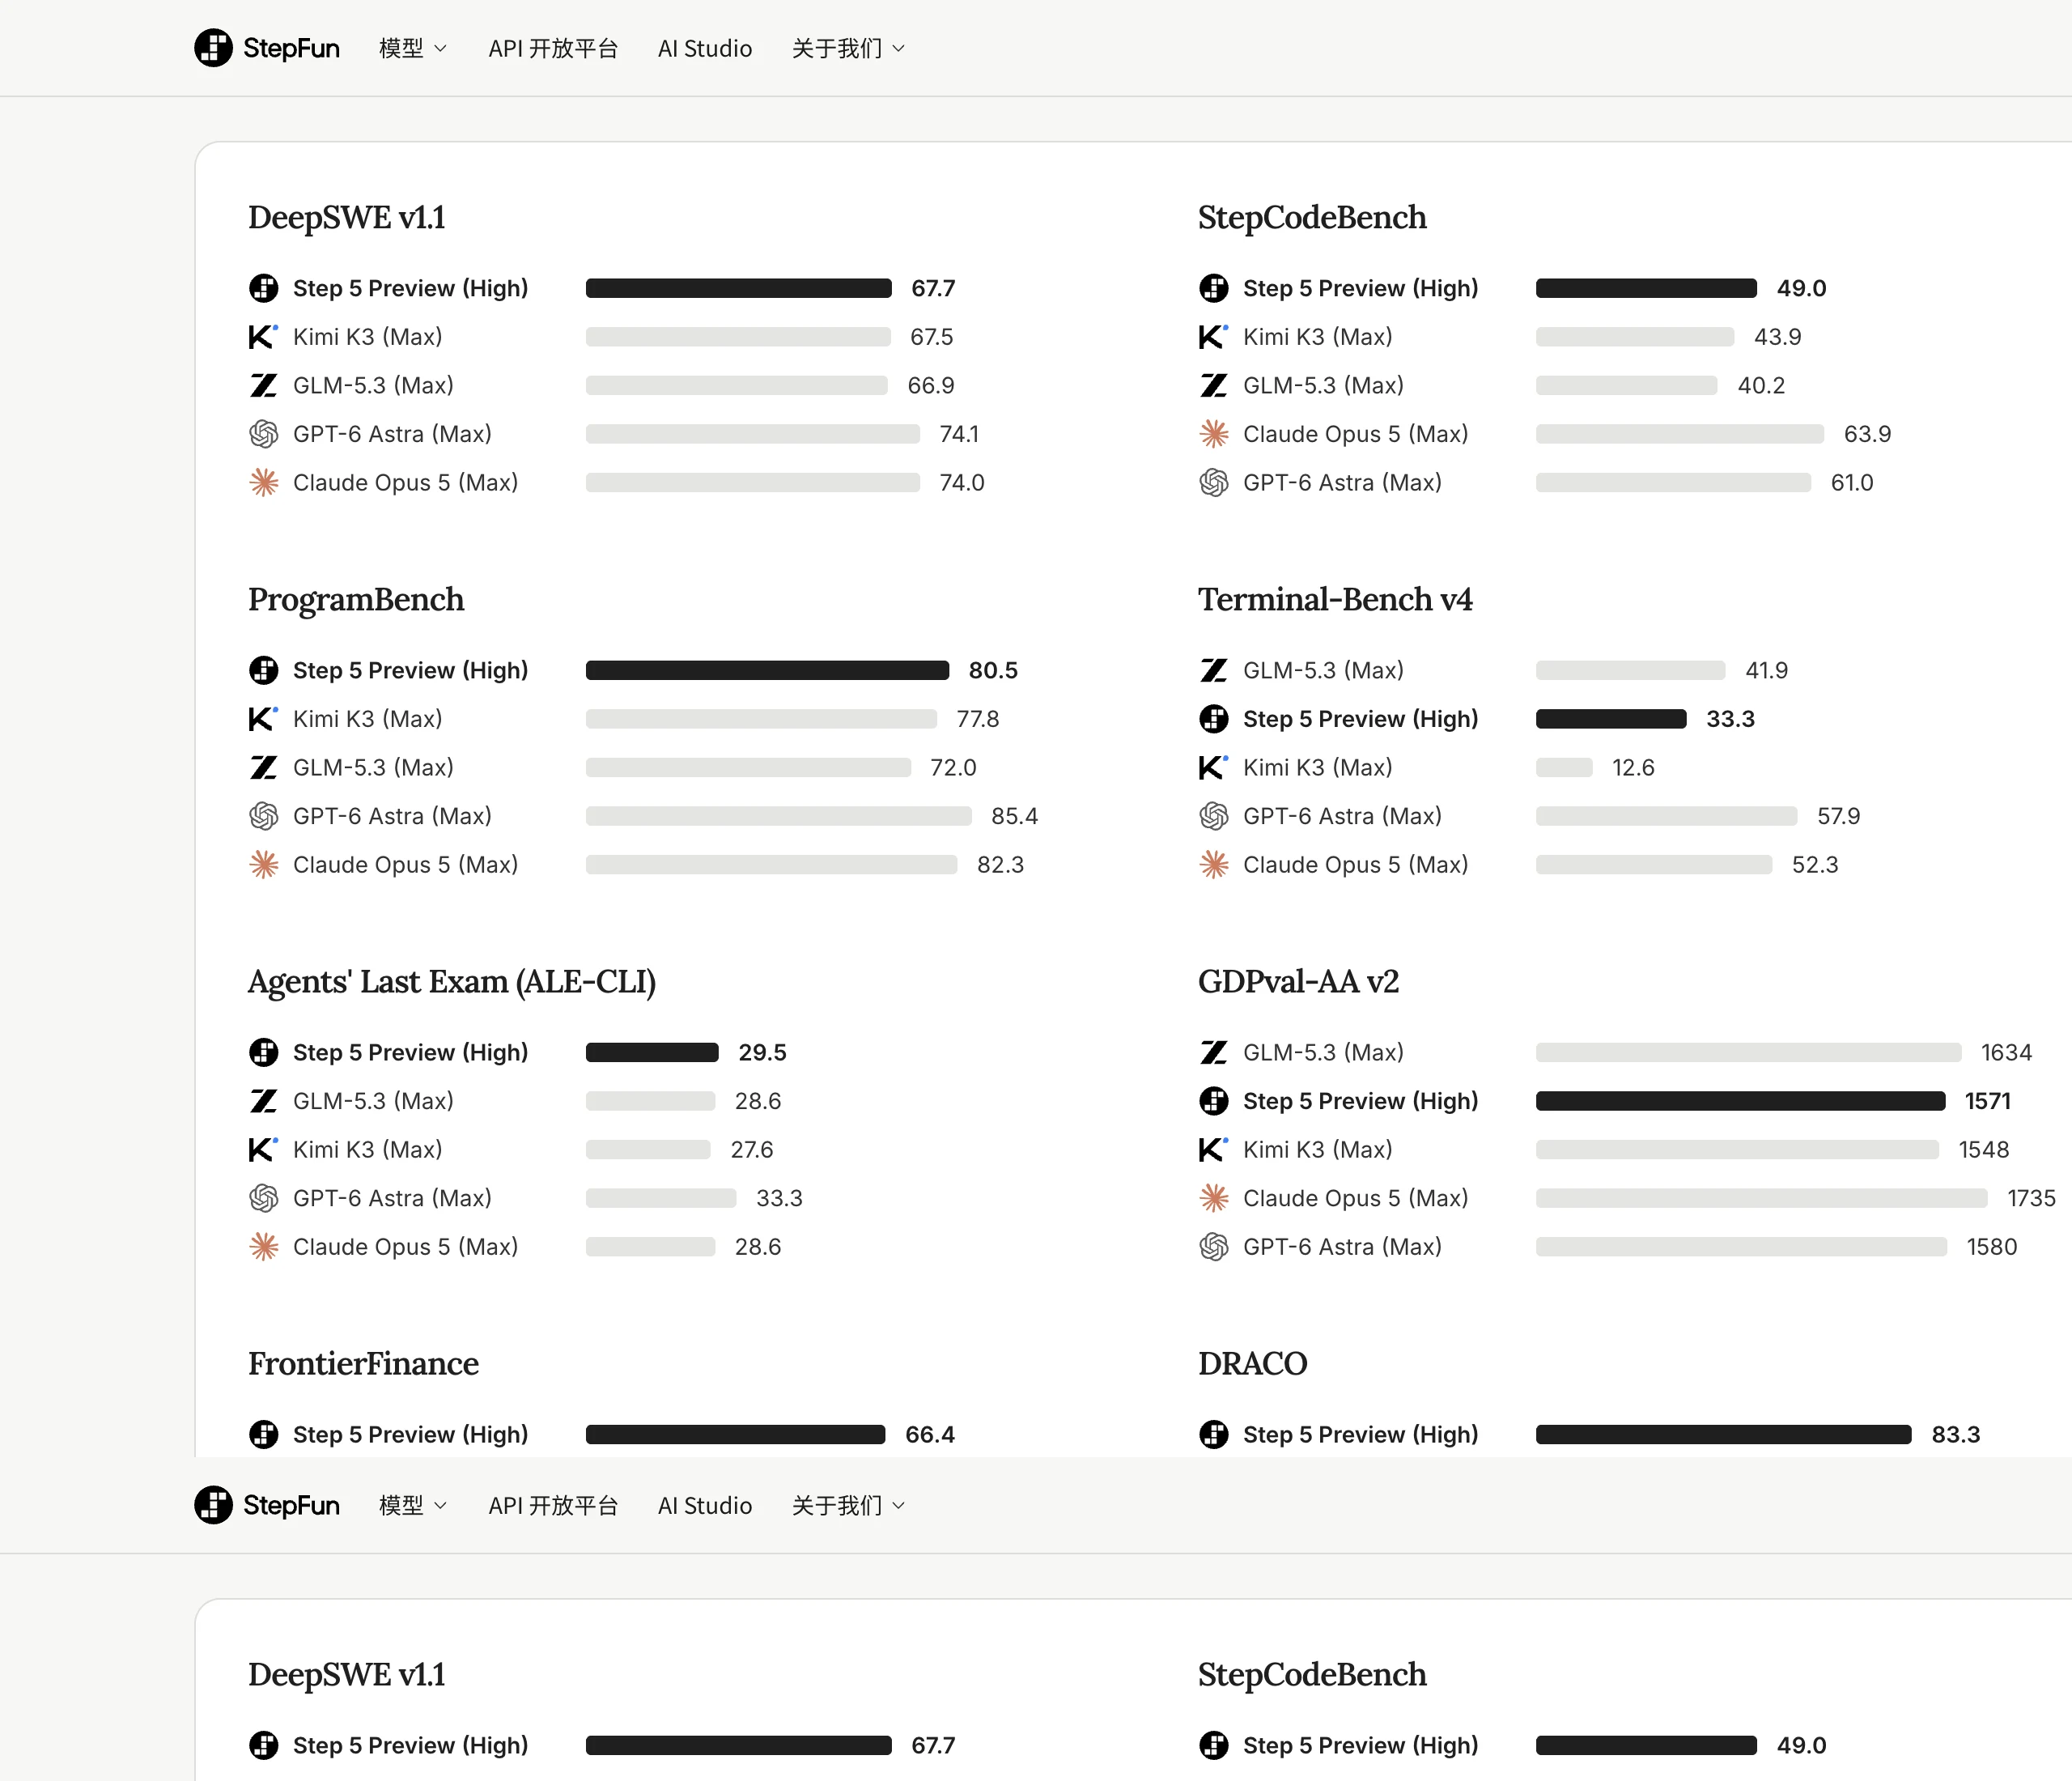
StepFun 발표문의 벤치마크 비교 화면입니다. DeepSWE v1.1과 StepCodeBench 점수가 모델별로 표시되어 있습니다.
발표문에 실린 벤치마크 비교 화면입니다. 평가 방식과 비교 조건을 회사가 설계했다는 점을 함께 읽어야 합니다.· 사진: StepFun 발표문 화면 · 분석 목적 인용

회사는 실무형 코딩 평가를 위해 StepCodeBench를 새로 만들었다고 밝혔습니다. 독립 코드 저장소 553곳, 과제 유형 9종, 응용 분야 20개, 프로그래밍 언어 33개를 다루며 산업 수요와 실제 사용자 요청, 전문가 작업 기록을 반영했다는 설명입니다. 이 벤치마크에서 Step 5 Preview는 49.0점으로 Kimi K3(43.9점)와 GLM-5.3(40.2점)을 앞섰지만 Claude Opus 5(63.9점)와는 거리가 있습니다. 공식

금융에서 두드러진 점수

Step 5 Preview의 가장 뚜렷한 우위는 금융입니다. 금융 전문 과제를 다루는 FrontierFinance에서 66.4점을 기록해 GPT-6 Astra(55.0점), Kimi K3(62.6점), GLM-5.3(64.1점)을 앞섰습니다. Claude Opus 5(69.7점)에는 못 미칩니다. 규제 문서 판독 평가 DRACO에서도 83.3점으로 GLM-5.3(82.3점), GPT-6 Astra(76.8점)보다 높았습니다. 공식

발표문은 인공지능 분석 업체 Artificial Analysis의 지수에서 Step 5 Preview가 44점을 받았고, 비슷한 지능 수준의 경쟁 모델보다 과제당 비용이 낮다고 강조합니다. GDPval-AA v2 점수는 같은 날짜 기준 GLM-5.3(1634점), Claude Opus 5(1735점)에 이은 1571점입니다. 공식

평가자 70%가 본 자율 코딩과 남은 과제

사내외 전문가 평가에서 응답자의 약 70%가 Step 5 Preview가 중간 난도 이상의 코딩 과제를 자율적으로 끝낼 수 있다고 답했다고 합니다. 발표문에는 사진 한 장에서 출발해 가구를 옮겨 볼 수 있는 3D 방 배치 도구, 3D로 다시 만든 Flappy Bird 게임 같은 사례가 예시로 실렸습니다. 공식

벤치마크 수치를 읽을 때 조건도 함께 봐야 합니다. DeepSWE v1.1 평가는 SWE-agent 하네스에서 온도 1.0, top_p 0.95 설정으로 이뤄졌고, StepCodeBench는 회사가 직접 설계한 평가입니다. GDPval-AA 점수는 Artificial Analysis가 2026년 9월 19일까지 공개한 결과를 인용했습니다. 독립적인 검증이 쌓이기 전까지는 회사 발표 수치로 읽는 것이 정확합니다. 공식
자주 묻는 질문

Step 5 Preview는 공개 가중치 모델입니까?
발표문에 가중치 공개 여부와 가격이 적혀 있지 않습니다. 이름에 Preview가 붙은 만큼 사전 공개 성격으로 읽는 편이 맞습니다.
최상위 모델보다 성능이 높습니까?
모든 영역에서 앞서지는 않습니다. 소프트웨어와 금융의 일부 지표에서 경쟁력을 보였지만 터미널 작업 Terminal-Bench v4에서는 33.3점으로 GPT-6 Astra(57.9)보다 낮습니다.
파레토 경계라는 표현은 무슨 뜻입니까?
지능과 비용을 동시에 개선해 같은 지능을 더 낮은 비용으로 얻는 경계선을 가리킵니다. 회사는 비슷한 인공지능 지수에서 과제당 비용이 더 낮다고 설명합니다.

출처 · 2

  1. 1StepFun Step 5 Preview 발표문공식 발표www.stepfun.com/step-5-preview
  2. 2해커뉴스 토론 스레드참고news.ycombinator.com/item?id=49772532

이 글의 마크다운 원문: /posts/stepfun-step-5-preview/md/ · 인용 시 출처를 “AI피셜”으로 표기해 주세요.

편집장의 새 책《의료 바이오 연구자를 위한 AI 신약개발 실전 가이드》 책 표지

의료 바이오 연구자를 위한
AI 신약개발 실전 가이드

Python 기초부터 QSAR·ChemBERTa·GNN,
분자 도킹까지 548쪽 실습서입니다.

책 소개 보기

도움이 됐다면

공유

더보기

다음으로 읽을 글

같은 태그·카테고리에서 세 편을 골랐습니다.

데이터센터 서버실에서 기술자가 노트북을 켜 놓고 서버 랙의 케이블을 정리하고 있다
모델· 8

AI 값 또 내려갈까? 딥시크가 줄인 ‘임시 기억’

딥시크 V4.1-Flash는 토큰당 KV 캐시를 이전 Flash의 약 4분의 1로 줄였습니다. 출력 100만 토큰은 오프피크 0.6달러. 이런 효율화가 다른 회사의 가격까지 바꿨을까요?

  • #DeepSeek
  • #오픈소스
  • #추론 비용
사무실 책상 위에 모니터·키보드·마우스와 함께 놓인 데스크톱 워크스테이션 본체
논문 한입· 5

CUA-Universe — CLI 섞은 9B, OSWorld 40.2%

상하이교통대·저장대 연구진이 데스크톱 앱 16종을 GUI+명령줄 혼합 환경으로 만들고 9B 모델을 학습해 OSWorld 성공률을 23.4%에서 40.2%로 올렸습니다. 방법과 수치를 정리했습니다.

  • #논문
  • #에이전트
  • #컴퓨터 사용
정부세종청사 북측 청사 건물군을 멀리서 바라본 전경
논문 한입· 5

KOPA-Bench — 한국 공공 API 2,318개로 에이전트 시험

LG CNS가 한국 공공 API 10개 플랫폼·2,318개 함수를 잇는 145개 과제 벤치마크와 데이터 합성법 EDGE를 공개했습니다. 9B 모델이 27B에 근접한 수치와 한계를 정리했습니다.

  • #논문
  • #에이전트
  • #벤치마크