생성과 편집을 한 모델로
알리바바의 Qwen 팀은 2026년 9월 20일 Qwen-Image-2.1을 공개했습니다. 텍스트로 이미지를 만드는 기능과 기존 이미지를 편집하는 기능을 한 파이프라인에 합친 모델이며, 가중치와 코드는 GitHub, Hugging Face, ModelScope에 함께 올라왔습니다. 해커뉴스에서는 하루 만에 570점이 넘는 반응을 얻었습니다. 공식
크기는 작습니다. 시각 생성부는 32층 단일 스트림 DiT(Diffusion Transformer, 확산 모델을 트랜스포머로 구성한 구조)로 70억 매개변수이고, 텍스트와 조건 이미지는 별도의 Qwen3-VL 8B가 읽습니다. 참조 이미지와 편집 지시를 캐시에 두고 매 단계 다시 처리하지 않는 Prefix KV Cache 설계로 여러 장을 참조하는 편집의 비용을 줄였다고 팀은 설명합니다. 공식
배경을 지우지 않고 처음부터 투명하게
가장 눈에 띄는 기능은 투명 이미지 생성입니다. 지금까지 투명 배경 이미지는 보통 일반 이미지를 만든 뒤 배경 제거 도구를 한 번 더 돌려 얻었습니다. Qwen-Image-2.1은 64채널 RGBA 오토인코더를 써서 알파 채널(alpha channel, 픽셀마다 투명도를 담는 정보)을 생성 결과 자체에 포함합니다. 2025년 12월 별도 모델이었던 Qwen-Image-Layered의 기능을 한 모델로 통합한 것입니다. 공식
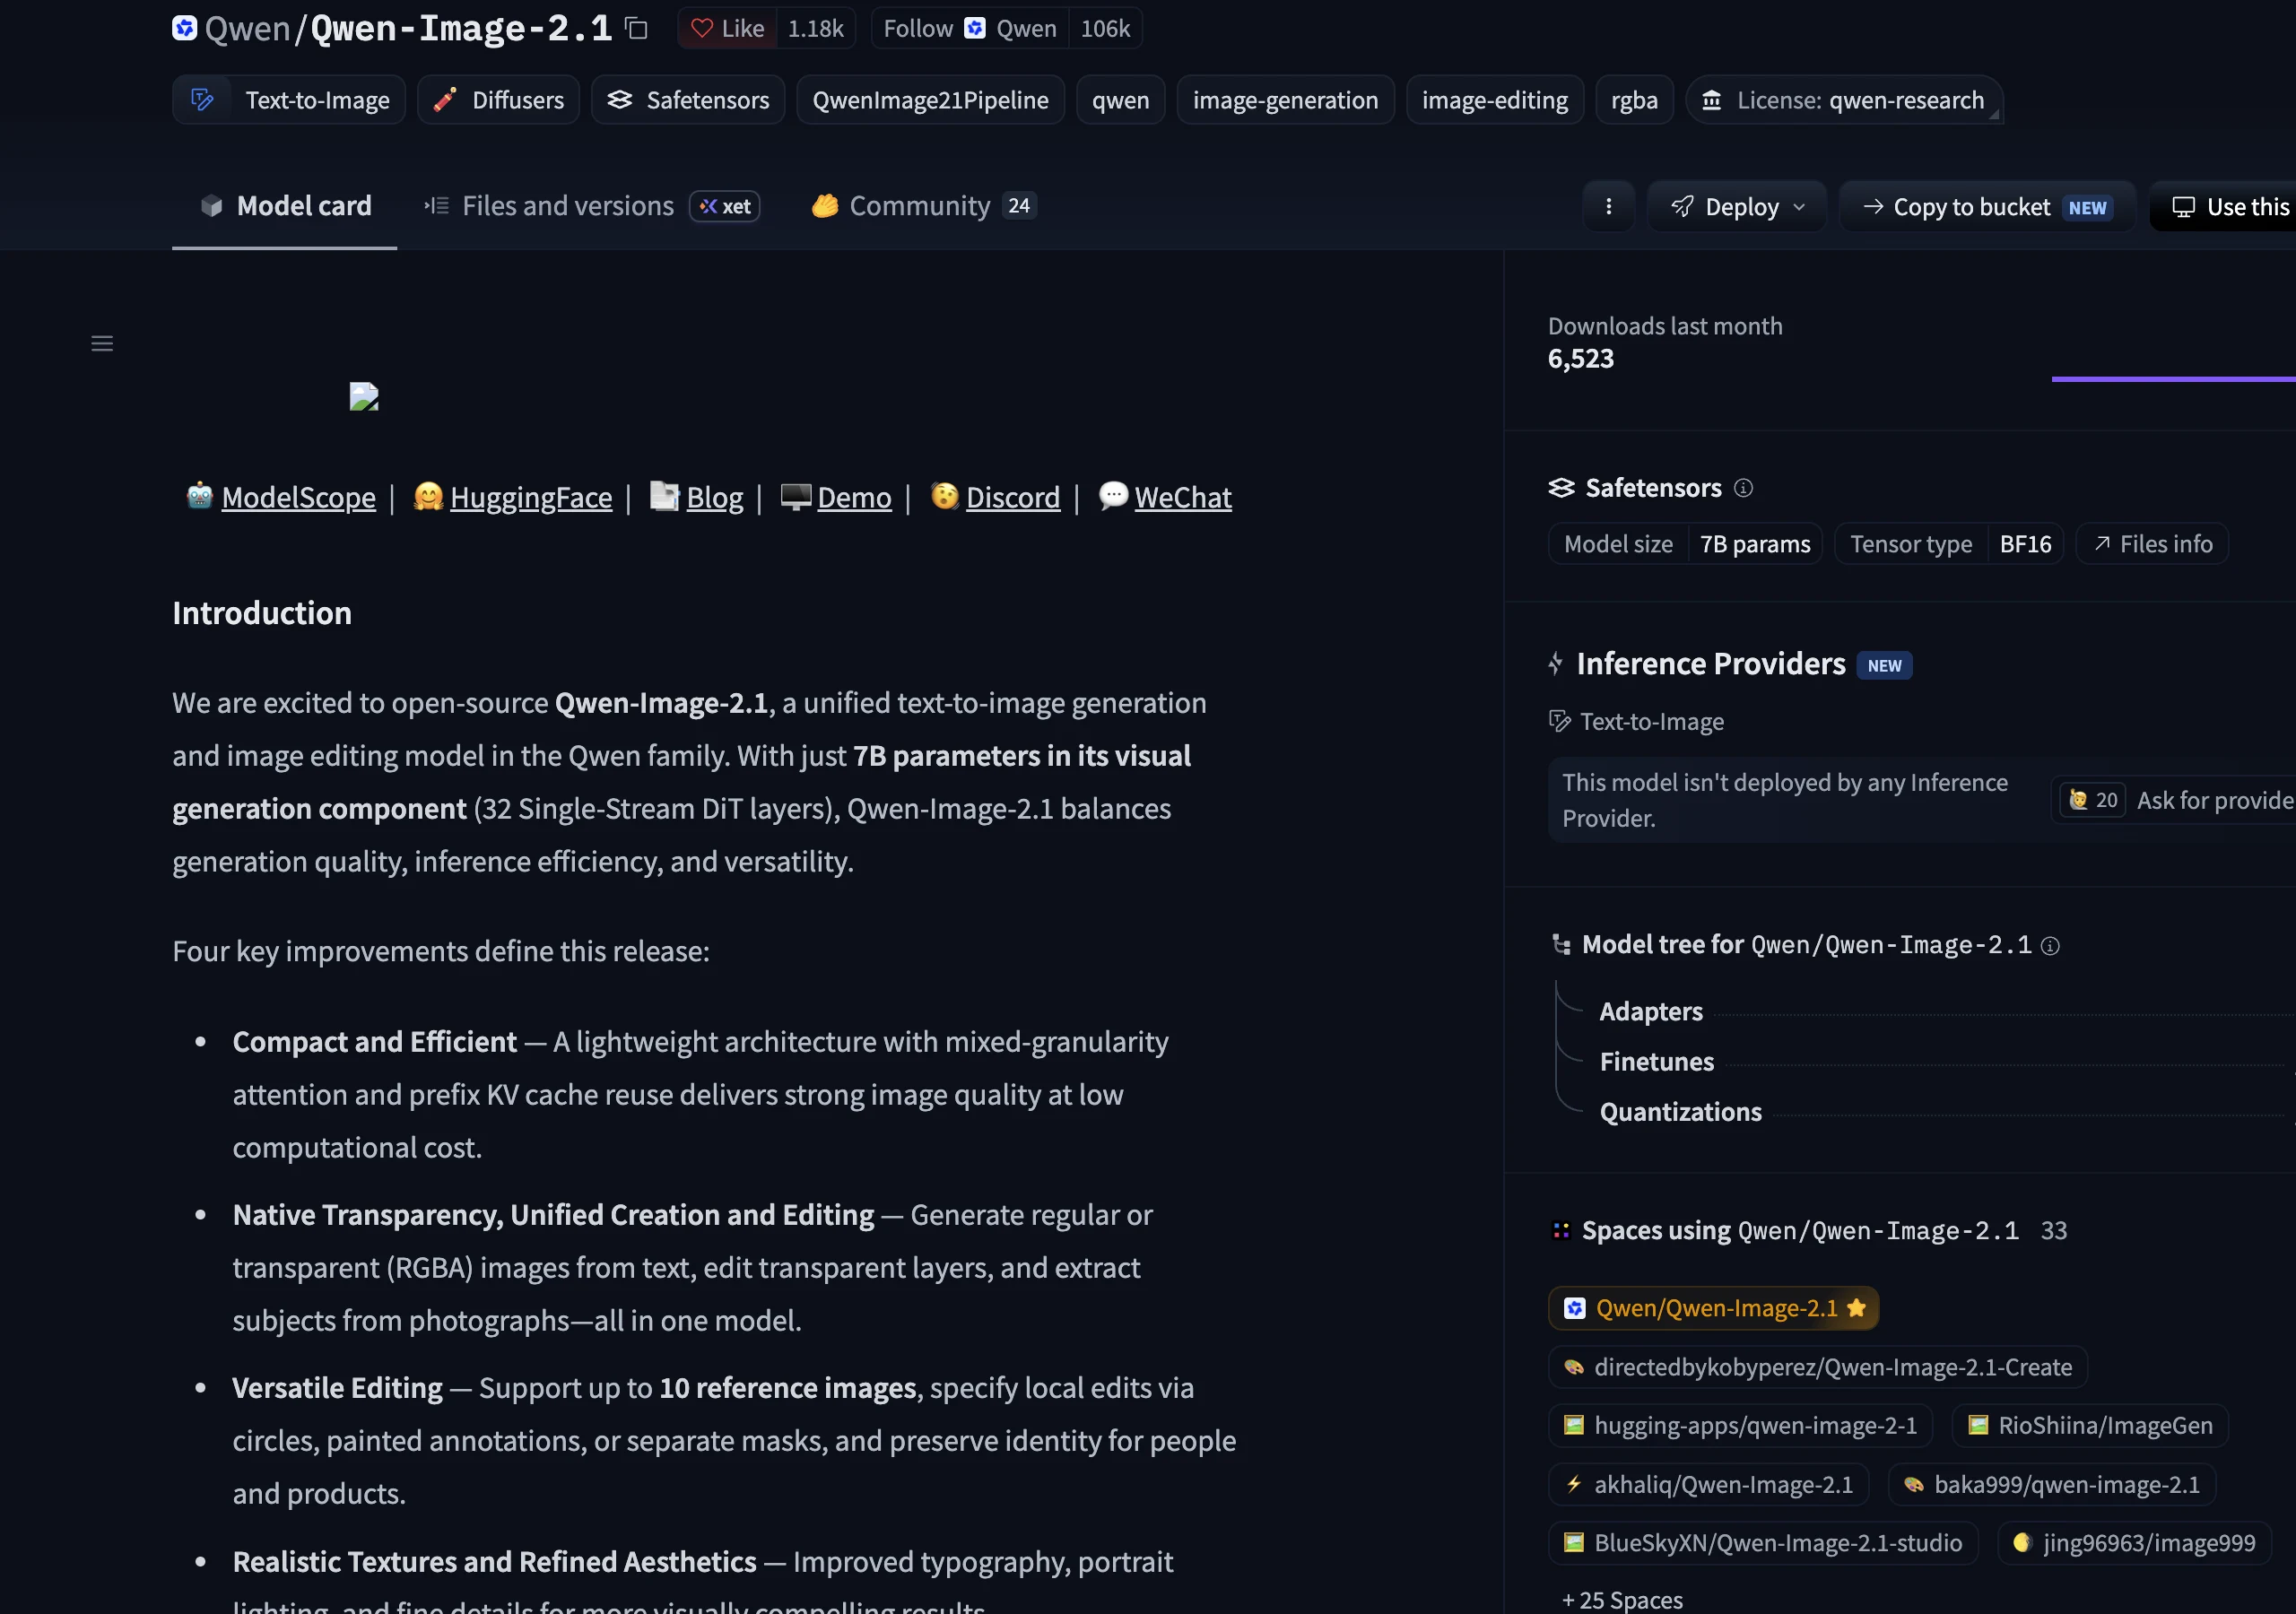
공개 예시는 세 갈래입니다. 프롬프트만으로 투명 배경의 캐릭터나 여러 요소가 겹친 구성물을 만들고, 이미 투명한 자산의 표정이나 글자를 배경을 유지한 채 바꾸며, 일반 사진에서 피사체만 투명 자산으로 뽑아냅니다. 저장소는 투명 이미지를 원할 때 “This is an RGBA image with transparency”로 시작하는 프롬프트 형식을 권장합니다. 공식
참조 10장, 원 표시 편집, 2K
편집 쪽도 넓어졌습니다. 참조 이미지를 최대 10장까지 받아 인물, 옷, 신발, 가방 같은 여러 요소를 한 장으로 합칠 수 있고, 원을 그리거나 칠한 표시, 별도 마스크로 고칠 영역을 지정하는 부분 편집을 지원합니다. 출력은 2K이며 기본 추론 단계는 40입니다. Diffusers, ComfyUI, vLLM-Omni, SGLang, LightX2V가 공개 당일 지원을 밝혔습니다. 공식
| 항목 | Qwen-Image-2.0 | Qwen-Image-2.1 |
|---|---|---|
| 생성+편집 통합 | 지원 | 지원 |
| 투명(RGBA) 생성 | 미지원 | 지원 |
| 참조 이미지 | 제한적 | 최대 10장 |
| 원·마스크 부분 편집 | 제한적 | 지원 |
| 첫날 ComfyUI | 미지원 | 지원 |
수치는 회사가 낸 값입니다
팀은 자체 평가 Qwen-Image-Bench에서 60.28점을 보고했고, 같은 표에 Nano Banana 2.0을 59.82점, GPT Image 1.5를 59.65점으로 실었습니다. 평가 문항과 채점 기준을 회사가 만들었으므로 독립 평가와 구분해 읽어야 합니다. 라이선스는 Qwen Research License로 안내됐고, 상업 이용 조건은 원문 확인이 필요합니다. 공식
7B라는 숫자도 조건이 붙습니다. 이는 시각 생성부만의 크기이고 인코더 Qwen3-VL 8B가 별도로 돕니다. 그럼에도 커뮤니티가 주목한 지점은 크기가 아니라, 생성·편집·투명 출력·다중 참조라는 네 가지 작업을 하나의 작은 파이프라인으로 묶었다는 사실입니다. 보도