AI 모델이 만들어지는 과정은 보통 결과 발표로만 알려집니다. 얼마나 오래 학습했는지, 도중에 무엇이 고장 났는지는 논문이나 기술 보고서에 나중에 짧게 적히는 경우가 많습니다. 샤오미 MiMo 팀은 이 과정을 거꾸로 공개했습니다. 다음 모델 mimo-v2.6을 다듬는 강화학습 실행을 대시보드로 실시간 보여 주고 있습니다. 공식
무엇을 학습하고 있습니까
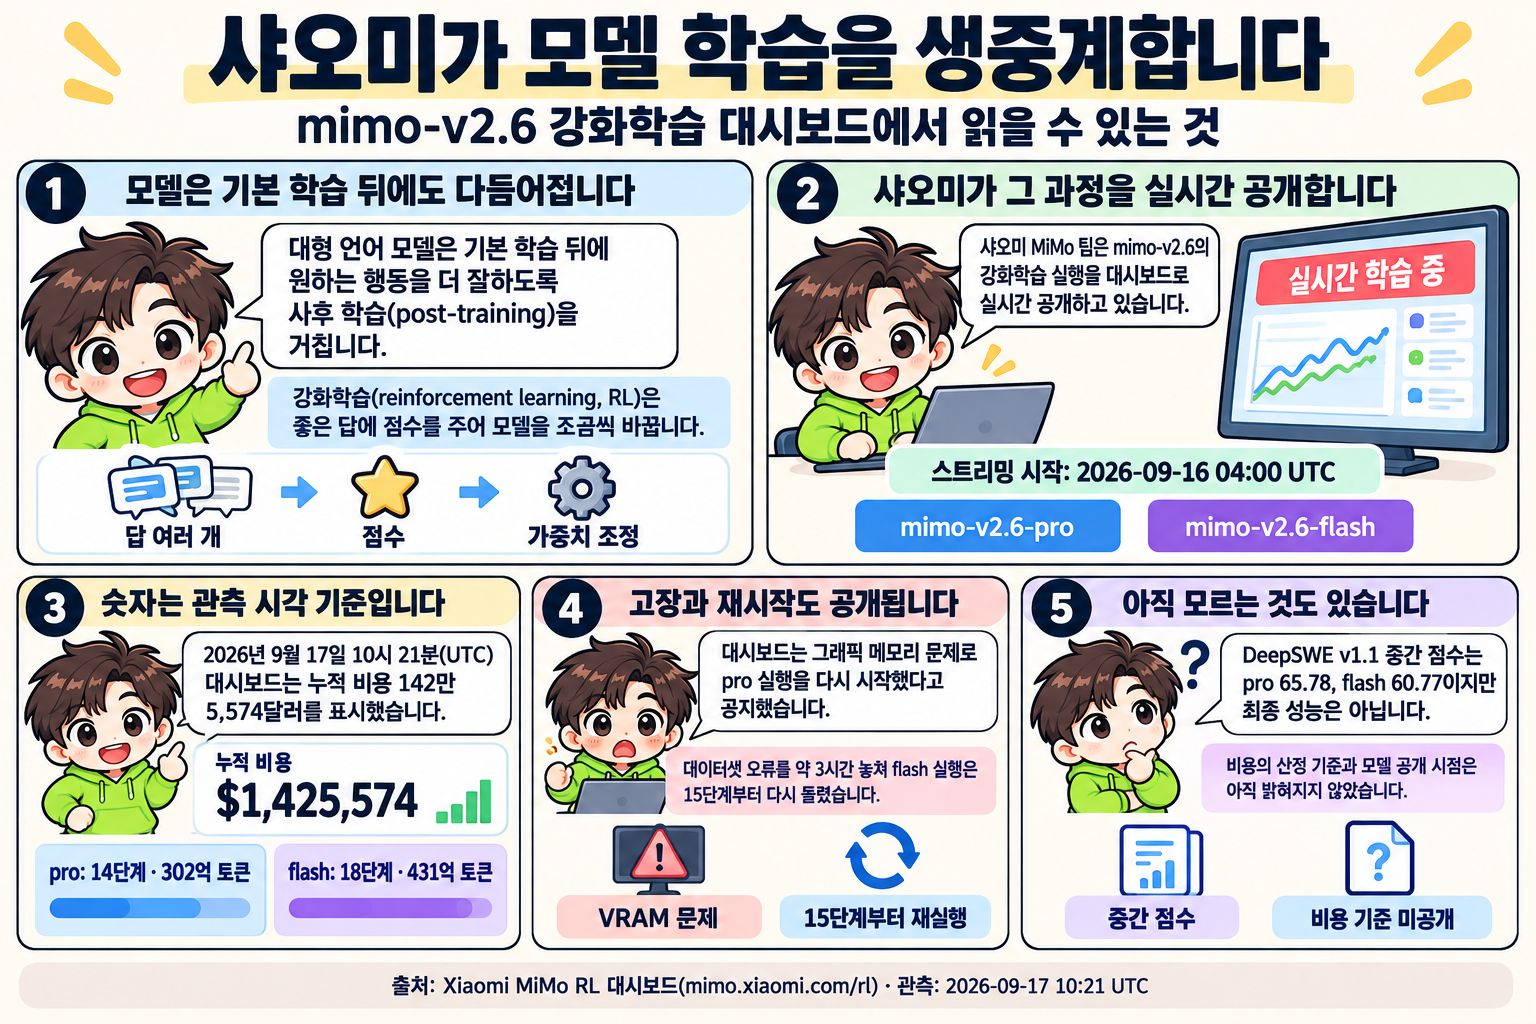
대형 언어 모델은 대량의 글로 기본 능력을 익힌 뒤, 원하는 행동을 더 잘하도록 추가로 다듬는 사후 학습(post-training)을 거칩니다. 강화학습(reinforcement learning, RL)은 그 방법 중 하나로, 모델이 여러 답을 내면 점수를 매겨 좋은 답 쪽으로 가중치를 조금씩 옮깁니다.
대시보드의 about 탭은 “RL 대형 실행을 스트리밍하고 있다”며 mimo-v2.6 시리즈가 곧 나온다고 밝힙니다. 스트리밍 시작 시각은 2026년 9월 16일 04:00 UTC로 적혀 있습니다. 화면에는 mimo-v2.6-pro와 mimo-v2.6-flash 두 실행이 나란히 표시됩니다. 대시보드는 두 모델의 크기나 규격을 밝히지 않습니다. 공식
숫자로 본 두 실행
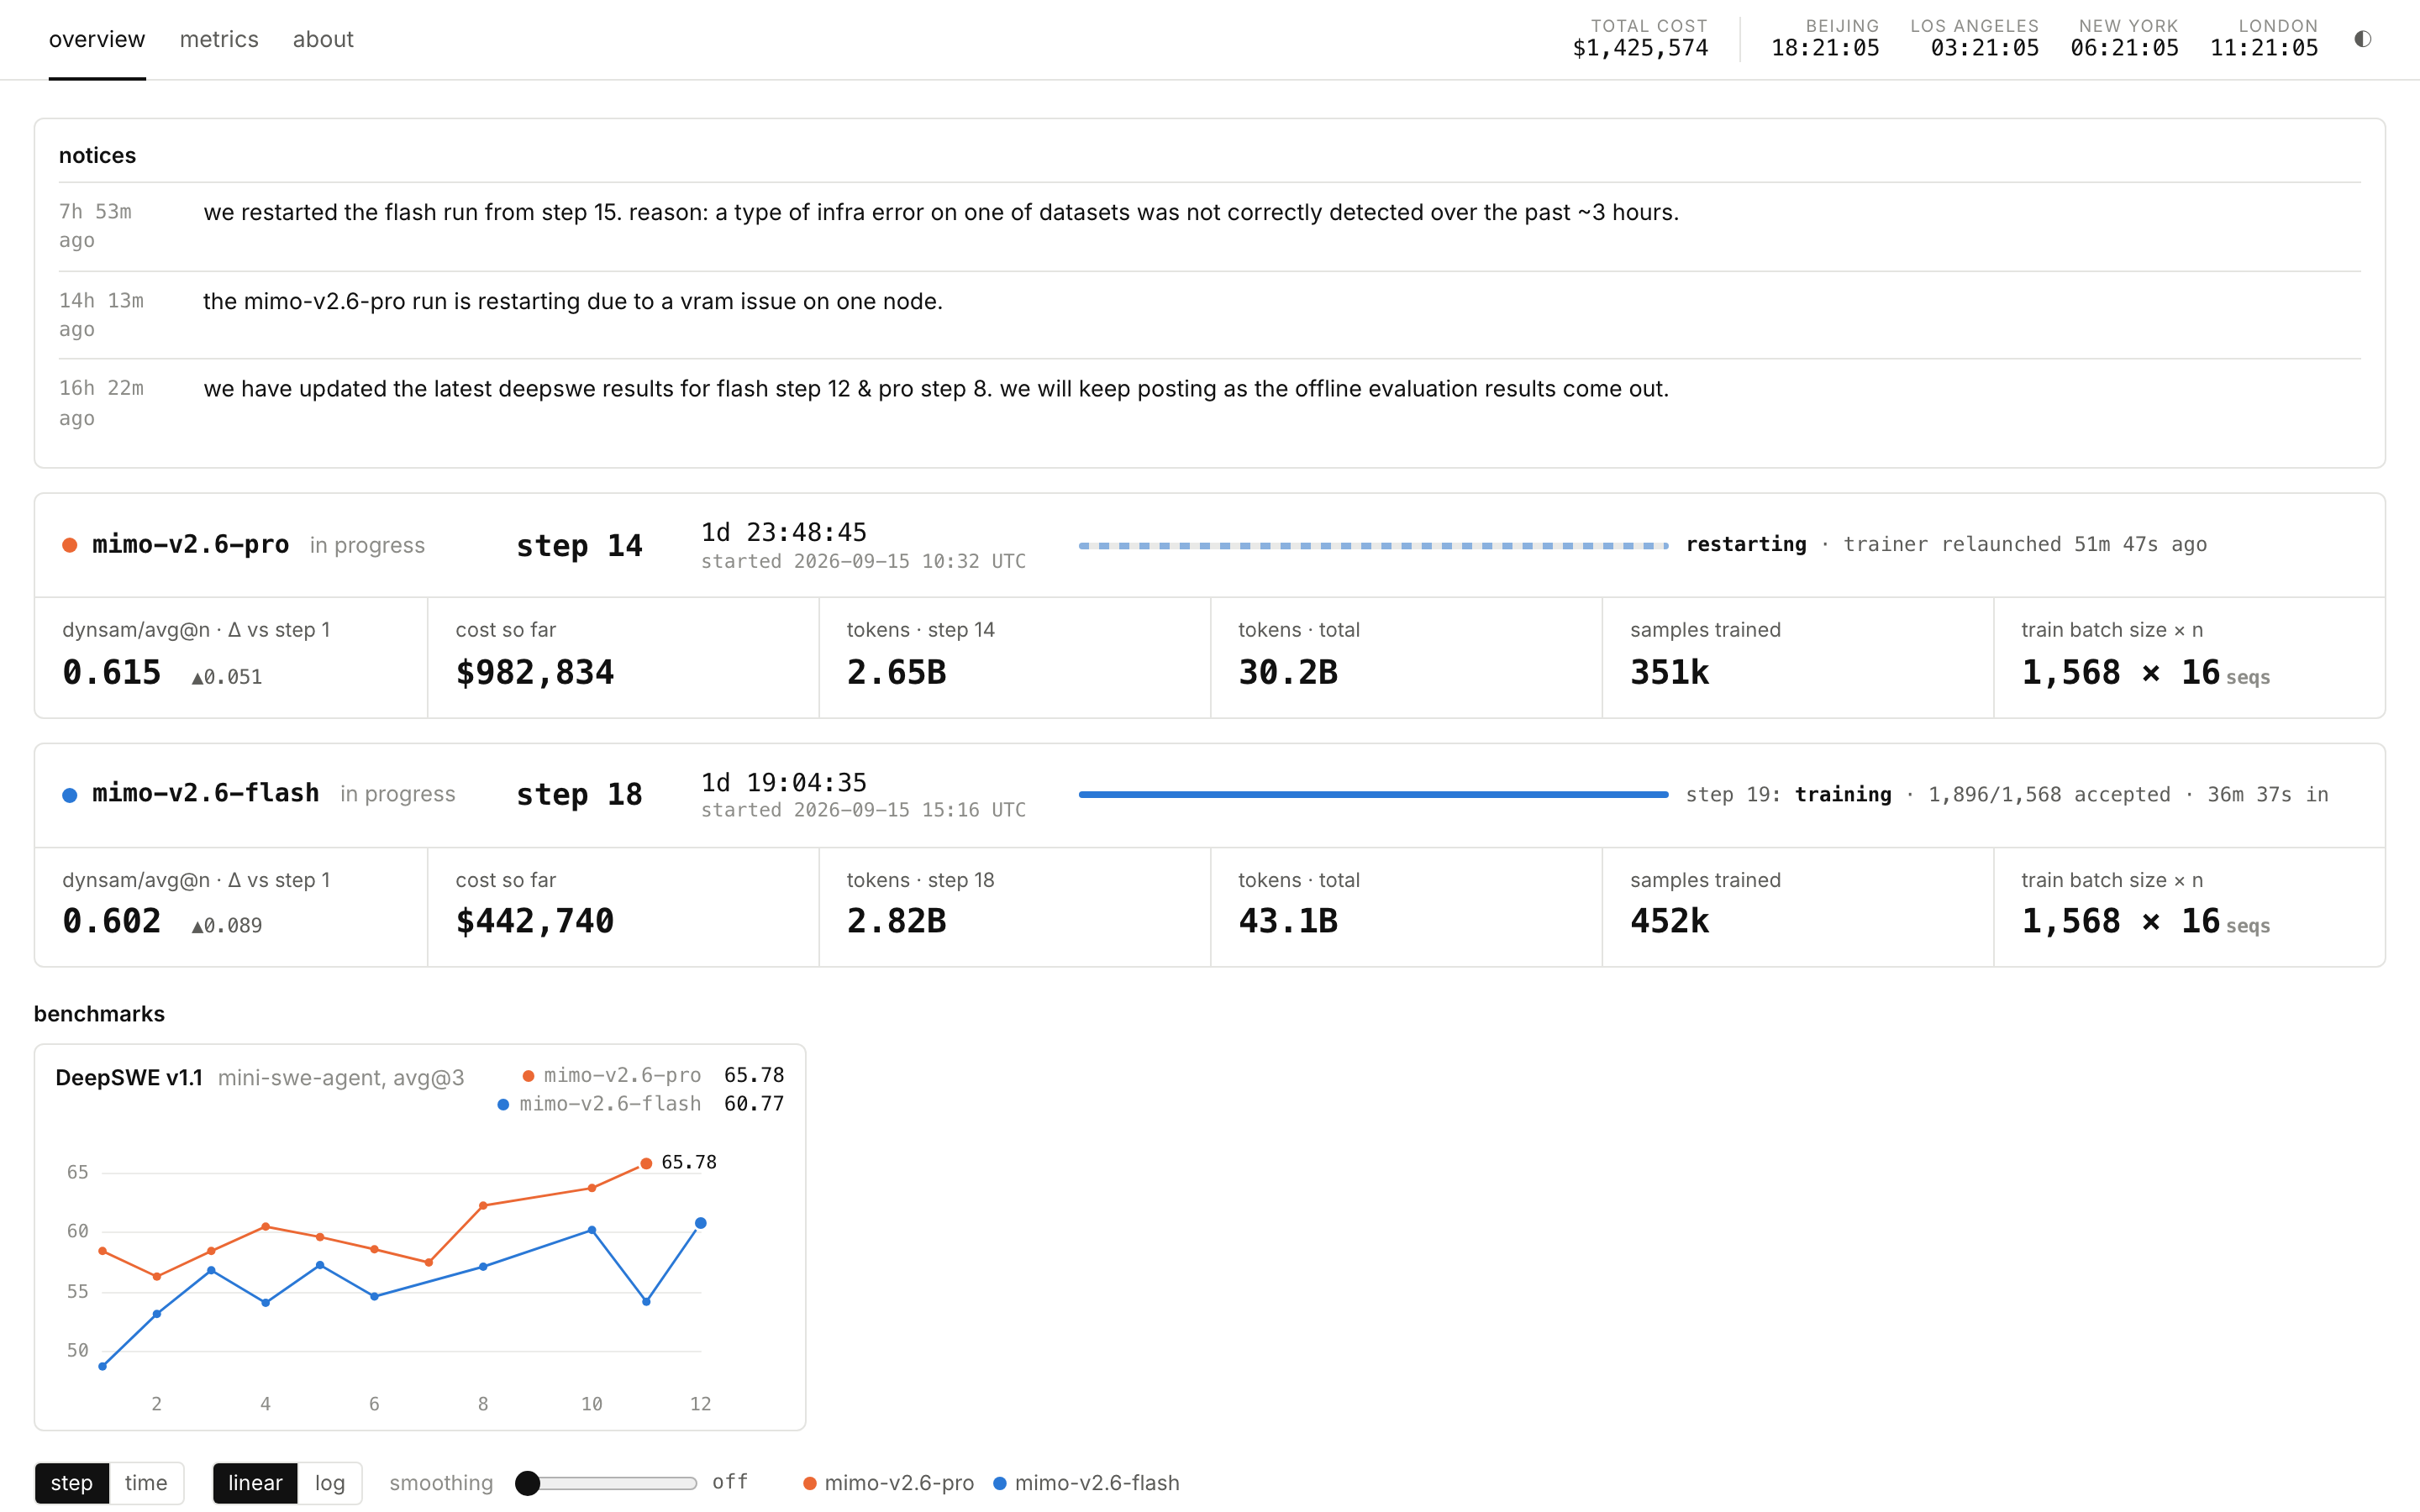
9월 17일 10시 21분(UTC) 관측 기준 전체 누적 비용은 142만 5,574달러였습니다. 9월 15일 10시 32분에 시작한 pro 모델은 14단계까지 진행했고 누적 비용 98만 2,834달러, 토큰 302억 개, 학습 샘플 35만 1천 개를 기록했습니다. 같은 날 15시 16분에 시작한 flash 모델은 18단계, 44만 2,740달러, 토큰 431억 개, 학습 샘플 45만 2천 개였습니다. 두 모델 모두 학습 배치 크기를 “1,568 × 16 seqs”로 표시합니다. 한 단계에서 1,568개 입력마다 16개 응답을 만든다는 뜻으로 읽힙니다. 데이터
다만 대시보드는 비용이 무엇을 합친 금액인지 설명하지 않습니다. GPU 사용료인지 내부 원가를 달러로 환산한 값인지 알 수 없으므로, 이 숫자는 샤오미가 공개한 표시값으로 읽어야 합니다.
고장도 그대로 보입니다
이 대시보드에서 가장 드문 정보는 장애 공지입니다. 관측 시각 기준 약 14시간 전 공지는 한 노드의 그래픽 메모리(video RAM, VRAM) 문제로 pro 실행을 다시 시작한다고 알렸습니다. 약 8시간 전 공지는 데이터셋 하나의 인프라 오류를 약 3시간 동안 제대로 감지하지 못해 flash 실행을 15단계부터 다시 돌렸다고 밝혔습니다. 공식
대형 학습에서 장비와 데이터 문제가 생기는 일은 드물지 않지만, 그 사실과 대처가 실시간으로 공개되는 경우는 드뭅니다. 독자는 모델 성능 뒤에 이런 재시작과 확인 작업이 쌓인다는 점을 직접 볼 수 있습니다.
중간 점수와 아직 모르는 것
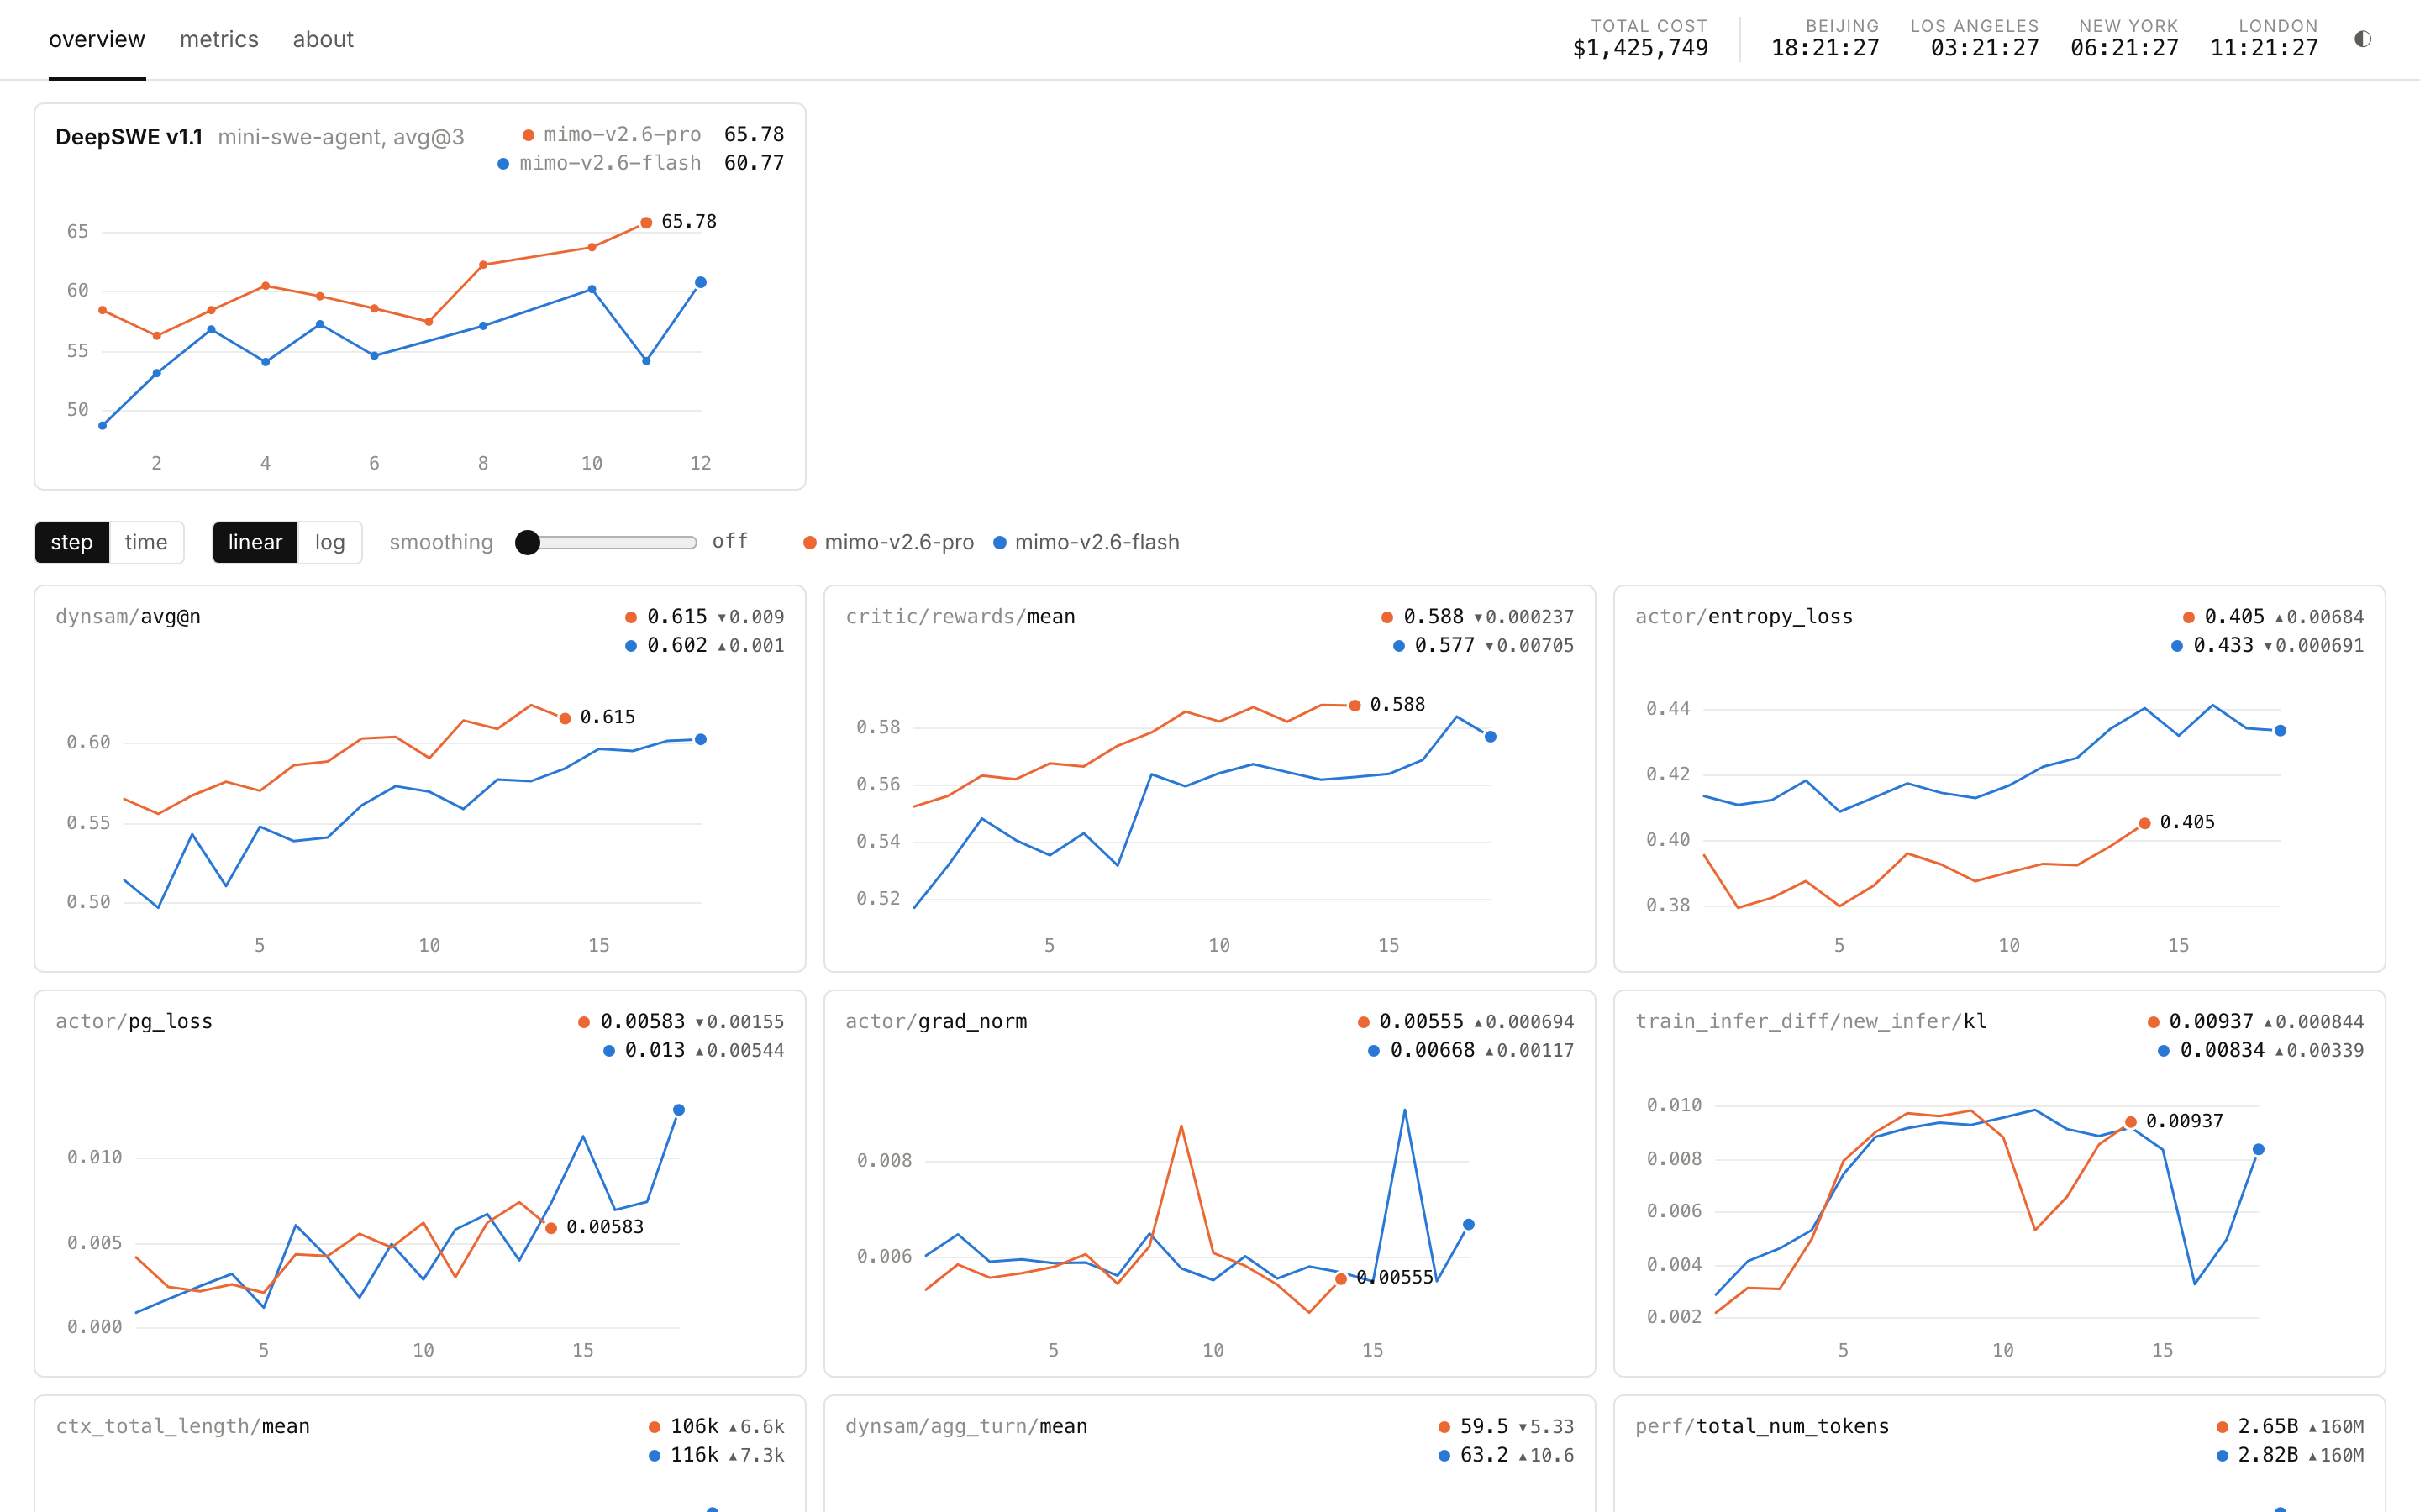
코딩 에이전트가 실제 소프트웨어 문제를 푸는 능력을 재는 DeepSWE v1.1 벤치마크에서, 대시보드는 pro 65.78, flash 60.77을 표시했습니다. 평가 방식은 mini-swe-agent로 세 번 실행한 평균(avg@3)이라고 적혀 있습니다. 이는 학습 도중 특정 단계에서 잰 중간 점수이며, 완성 모델의 공식 성능은 아닙니다. 데이터
이 대시보드는 9월 16일 20시 9분(UTC) Hacker News에 소개돼 17일 10시 14분 기준 436점과 댓글 114개를 받았습니다. 같은 날 20시 42분(UTC)에 달린 댓글은 더 많은 연구소가 이런 공개를 따라 하기를 바란다고 적었고, 20시 52분 댓글은 학습 도중 벤치마크를 돌리는 것이 평가 오염(contamination)에 해당하지 않느냐고 물었습니다. 보도
댓글
댓글 관련 문의: hello@aifficial.net
댓글을 불러오는 중입니다…