문장으로 답할 필요가 없는 질문
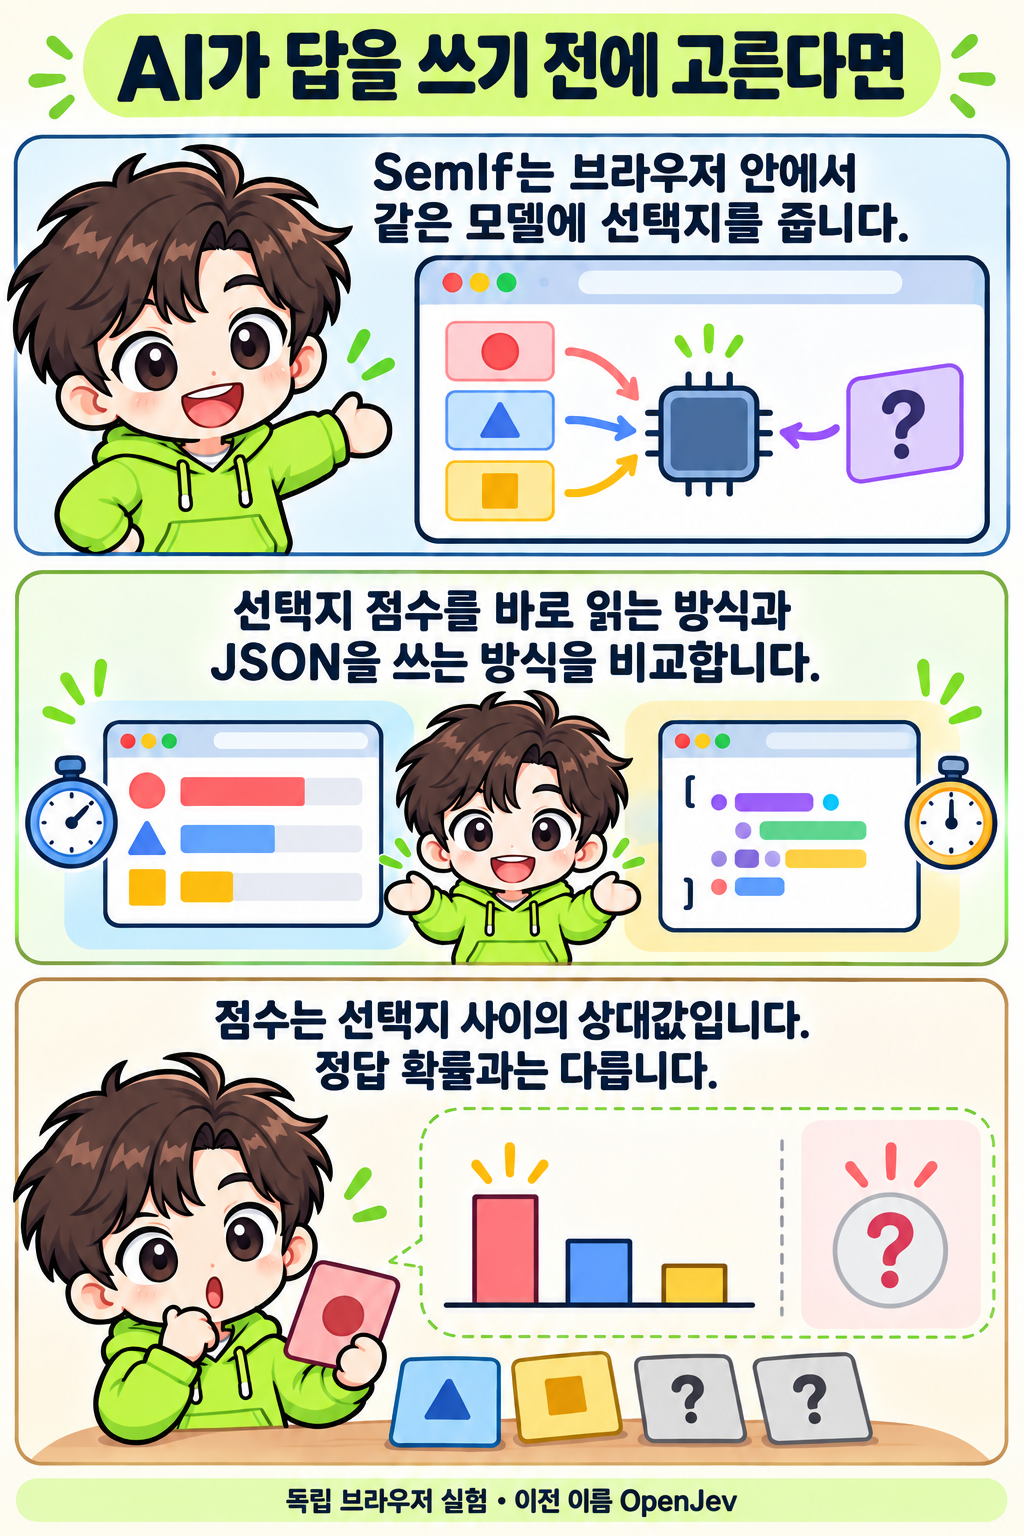
고객 문의를 결제, 로그인, 배송 중 어디로 보내야 할지 고른다고 생각해 보겠습니다. 앱에 필요한 결과는 세 선택지 중 하나인데, 챗봇은 그 답을 설명하는 문장이나 JSON까지 차례로 만들 수 있습니다. SemIf는 그 출력 과정을 줄였을 때 무엇이 달라지는지 브라우저에서 비교하는 실험입니다. 이전 이름은 OpenJev이며 TypeSafe의 Jev와 별개로 운영되는 프로젝트입니다. 공식
먼저 상태와 질문, 허용할 선택지를 입력합니다. 직접 읽기 경로는 모델의 선택지 점수인 로짓(logits)을 읽고, 주어진 선택지 사이에서 합이 1이 되도록 정규화합니다. 생성 경로는 같은 종류의 분포를 JSON 문장으로 한 토큰씩 씁니다. 두 경로에 같은 판단 문제를 주지만 출력하는 방법이 다릅니다. 공식
같은 기기에서 시간을 따로 잽니다
SemIf는 하나의 로컬 모델에서 두 경로를 차례로 실행합니다. 동시에 실행해 기기 자원을 서로 차지하는 상황을 피하려는 구성입니다. 초기 다운로드와 준비 시간, 판단 시간, 생성 첫 토큰과 전체 완료 시간을 나누어 보여 줍니다. 화면의 시간은 실행한 기기에서 얻은 값이므로 다른 기기의 속도로 그대로 옮길 수 없습니다. 공식
바탕의 wllama는 llama.cpp를 웹어셈블리(WebAssembly, Wasm)로 브라우저에서 실행하는 라이브러리입니다. Wasm은 브라우저가 실행할 수 있는 코드 형식으로, 웹페이지 안에 계산기를 넣는 것과 비슷하게 모델 실행 기능을 옮길 수 있습니다. 브라우저에서 돌린다는 사실만으로 계산량이나 다운로드가 사라지는 것은 아닙니다. 공식
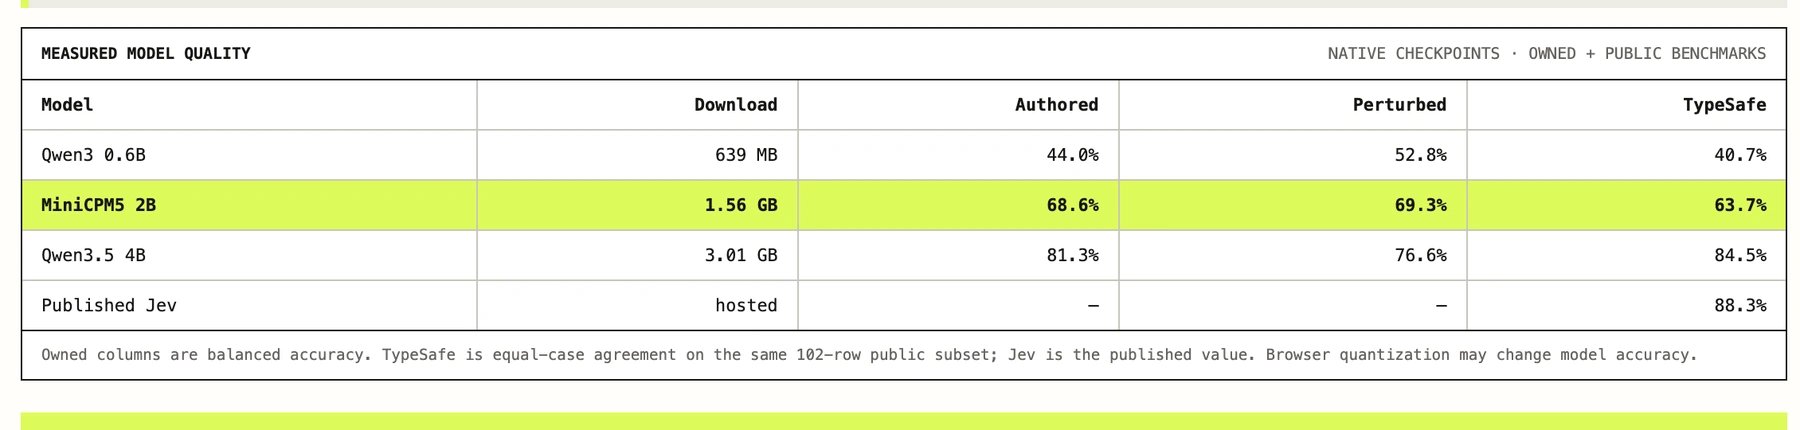
기본 선택 모델은 MiniCPM5 2B의 GGUF 배포본이며 화면은 다운로드를 1.56GB로 표시합니다. GGUF는 모델 가중치와 실행에 필요한 정보를 담는 파일 형식입니다. 공개 모델 페이지와 브라우저 데모는 각각 모델 배포와 실행 환경을 담당합니다. 작은 기기에서는 크기뿐 아니라 사용 가능한 메모리도 확인해야 합니다. 공식
선택지 밖에 답이 있다면
상대 점수는 선택지를 어떻게 만들었는지에 영향을 받습니다. '기타'가 빠진 문의 분류에서 가장 높은 값을 얻은 항목이 실제 정답이라고 보장할 수는 없습니다. SemIf도 점수가 보정된 신뢰도(calibrated confidence)가 아니라고 명시합니다. 보정된 신뢰도란 예컨대 80%라고 예측한 여러 사례 중 실제 정답 비율도 약 80%가 되도록 점검한 값입니다. 공식