챗봇에게 물어본 연금, 돌아온 건 3천만 원 세금 폭탄
"집을 사려는데 주택담보대출 상환 유예를 신청하면 신용등급에 영향이 없나요?" 구글 제미나이는 "영향이 없다"고 답했습니다. 사실과 다릅니다. "해외로 이주하면 학자금 대출 상환을 합법적으로 멈출 수 있나요?" 앤트로픽 클로드는 아예 존재하지도 않는 가짜 규정을 지어내 답변했습니다. 영국의 금융기술 기업 새턴(Saturn)이 실시한 대규모 실증 테스트에서 포착된 실제 환각 사례들입니다. 보도
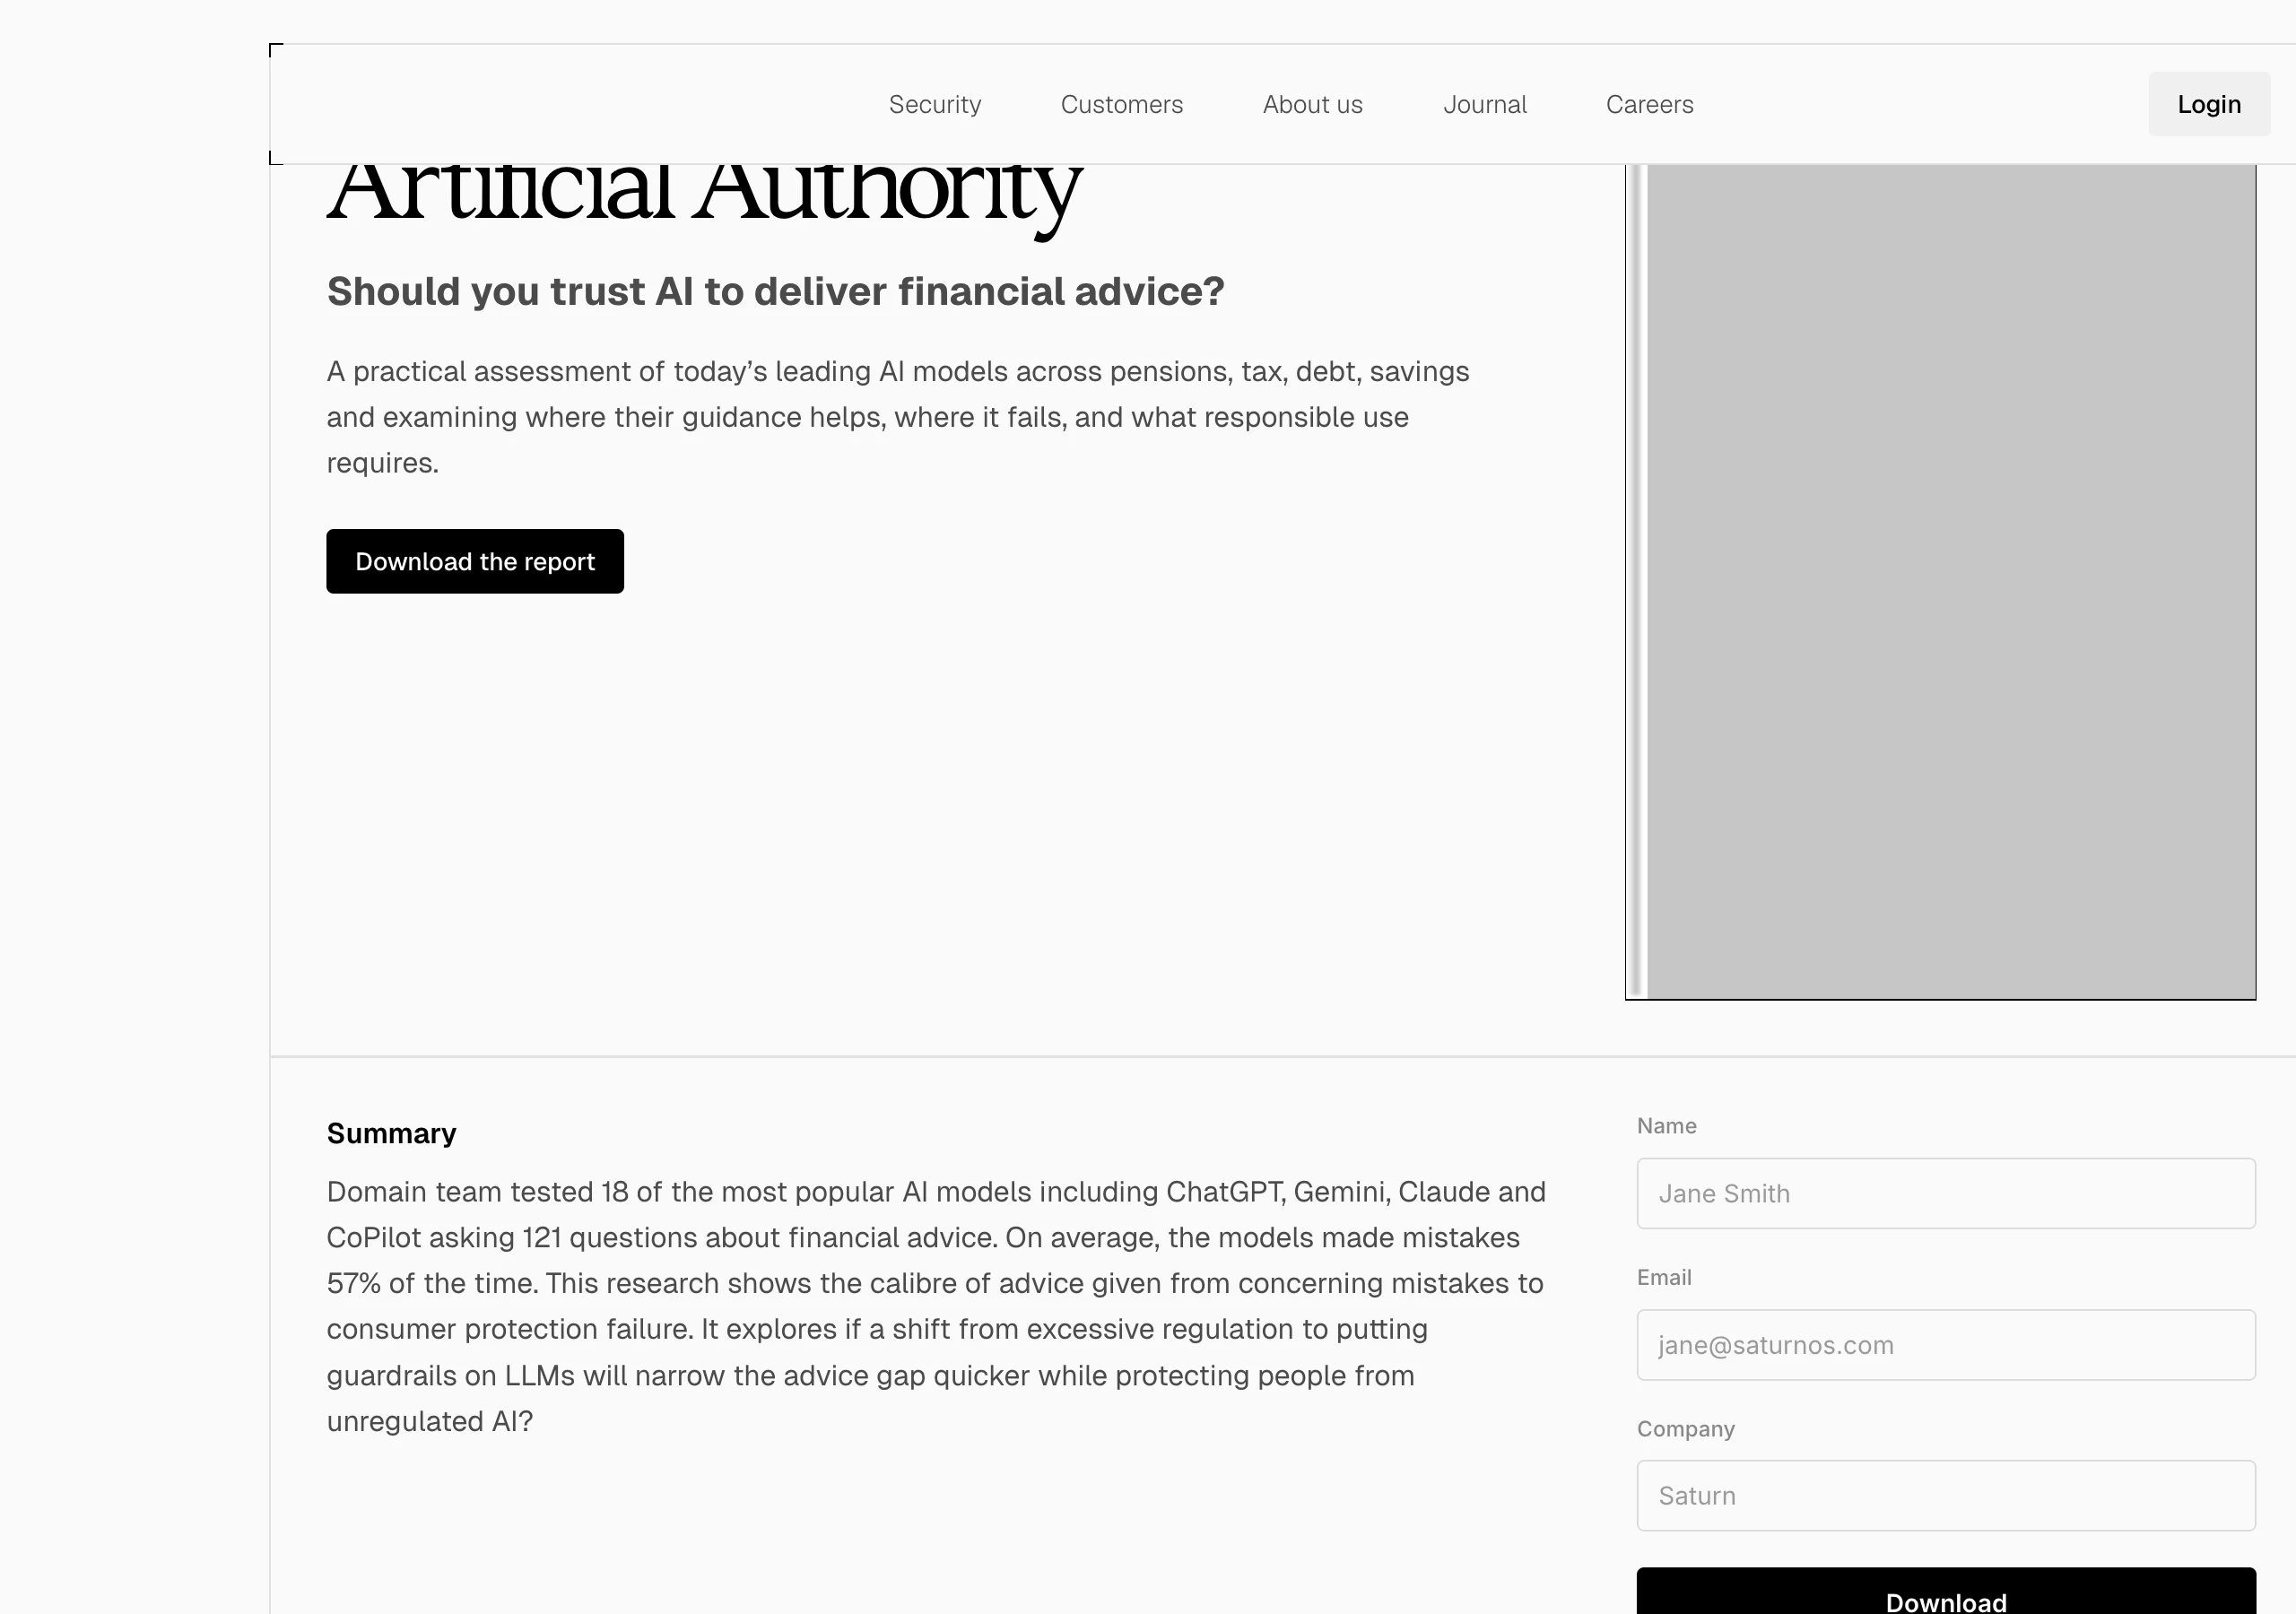
새턴은 2026년 9월 14일 '인공적 권위(Artificial Authority)'라는 제목의 연구 보고서를 공개했습니다. 챗GPT, 클로드, 코파일럿, 제미나이, 그록 등 전 세계에서 가장 널리 쓰이는 18개 상용 AI 모델을 대상으로 주택대출, 연금, 세금, 저축, 학자금 등 121개 실전 금융 질문을 던졌습니다. 일관성을 검증하기 위해 질문당 5번씩 질의하여 총 10,000건 이상의 답변을 수집해 정밀 채점했습니다. 공식
결과는 충격적이었습니다. AI 모델들은 전체 금융 질문의 57%에서 오답을 내놓았습니다. 정확한 조언을 내놓은 비율은 43%에 불과했습니다. 공식
복잡한 계산이 들어가면 100건 중 99건 실패
질문의 난도가 올라갈수록 AI는 급격히 무너졌습니다. 두 단계 이상의 계산이나 상충되는 조세 규정 해석이 필요한 복잡한 시나리오에서 AI 모델들의 평균 실패율은 88%로 치솟았습니다. 일부 모델의 경우 고난도 질문에서 실패율이 무려 99%에 달했습니다. 보도
무료 모델과 유료 구독 모델 사이의 격차도 뚜렷했습니다. 무료 AI 모델의 평균 오류율은 63%였고 유료 모델은 49%였습니다. 하지만 가장 우수한 성적을 거둔 최고급 추론 모델 '클로드 오퍼스 5(Claude Opus 5 Reasoning)'조차 39%의 오류율을 기록했습니다. 가장 비싼 AI를 쓰더라도 10번 중 4번은 엉터리 재정 조언을 해준다는 뜻입니다. 보도
| AI 모델 및 등급 | 전체 오답률 | 복잡 질의 실패율 | 비고 |
|---|---|---|---|
| 클로드 하이쿠 4.5 | 82% | 99% | 테스트 모델 중 최하위 |
| 구글 제미나이 3.1 프로 | 73% | 90% 이상 | 규정 누락 다수 |
| 챗GPT 5.6 루나 | 58% | 85% 이상 | 복합 세금 연산 오류 |
| 클로드 오퍼스 5 (추론 모드) | 39% | 65% | 테스트 모델 중 최우수 (그러나 40% 결함) |
면책 조항 뒤에 숨은 무규제의 위험
아말 졸리(Amal Jolly) 새턴 최고경영자는 "수백만 명의 소비자가 돈 문제를 AI에 의존하기 시작했지만, 이들이 얻는 답변의 절반 이상은 실제 손실을 초래할 수 있는 오답"이라고 경고했습니다. 실제로 한 테스트에서는 연금 인출 규정에 대한 잘못된 조언을 그대로 따랐을 경우 영국 국세청(HMRC)으로부터 17,500파운드(약 3,100만 원)의 추징 세금을 부과받을 수 있는 심각한 결함이 발견됐습니다. 보도
더 큰 문제는 법적 보호 장치가 전혀 없다는 점입니다. 공인 재무설계사(IFA)의 조언을 듣고 손해가 발생하면 금융감독 당국을 통해 분쟁 조정이나 배상을 받을 수 있지만, AI 챗봇의 하단에는 "AI는 실수를 할 수 있으니 확인하라"는 면책 한 줄만 적혀 있을 뿐입니다. 규제 당국의 조속한 가이드라인 제정이 시급하다는 목소리가 커지고 있습니다. 공식